
Cavena 890
斯德哥尔摩 Cavena 系统的二进制字幕文件,北欧各广播机构用它交换字幕。先是关于节目的文件头,然后每条字幕一个 128 字节的数据块:入点和出点的帧、对齐方式和两行文本。
概览
| 扩展名 | .890 |
|---|---|
| 媒体类型 | 未注册 |
| 规范 | 未公开发布。Subtitld 参照 Subtitle Edit,其读写功能是根据广播机构的文件摸索出来的。 |
| 时间精度 | 一帧,从节目起点或从 0 开始计数。文件中没有写明帧率。 |
| 文本编码 | 由文件头中的语言选定的码表:拉丁文,重音符号位于字母之前;俄文、希腊文、阿拉伯文、希伯来文每个字母一个字节;中文使用 UTF-16 |
| 样式 | 斜体、七种颜色加白色,以及文本背后的方框 |
| 位置 | 左对齐、居中或右对齐。上下位置目前不明。 |
| 说话人 | 无 |
| 所在容器 | 无。随节目一同交付的文件。 |
文件结构
这不是文本,而是字节:388 字节的文件头,之后每条字幕一个 128 字节的数据块。
Header · 388 bytes
  Tears of Steel · English
  HLV23N.V · 10:00:00:00
Block · 128 bytes · number 16
  frame 900,575 to 900,613
  centred
  ·
  You're a jerk, Thom.
Block · 128 bytes · number 32
  …
- 1 · 文件头
节目的译名和原名;译者;每行的语言;字体;字幕条数;以及节目的起点。
- 2 · 时间
数据块的编号,然后是第一帧和最后一帧,从 00:00:00:00 开始计数。
- 3 · 文本
对齐方式,然后是两行,每行 51 字节。只有一行的字幕写在第二行,即下面那一行。
文件头
按位置列出目前已知的内容:
| 字节 | 内容 |
|---|---|
| 40 | 节目的译名,28 个字符 |
| 68 | 译者 |
| 146、147 | 第一行和第二行的语言:09 英语,07 丹麦语,28 瑞典语,1E 挪威语,56 俄语,70 希腊语,80 阿拉伯语,8F 希伯来语,90 和 91 中文 |
| 179 | 字幕条数,低字节在前 |
| 187 | 字体:拉丁文为 HLV23N.V,其他文字为 KYRIL4.V、GREEK4.V、ARA19N.V、HEBNOA.V、CCKM44.V |
| 218 | 节目原名 |
| 256 | 节目的起点,以文本写出:10:00:00:00 |
其余部分按 Subtitle Edit 在文件中所见的样子写出,含义不明。
逐字节解析数据块
上面的第一条字幕,按 Subtitld 的写法,节目起点为 10:00:00:00,每秒 25 帧:
| 字节 | 内容 | 含义 |
|---|---|---|
| 0 | 00 10 |
编号 16。编号相同的数据块属于同一条字幕。 |
| 2 | 0D BD DF |
入点 第 900,575 帧:10:00:23:00 |
| 5 | 0D BE 05 |
出点 第 900,613 帧:10:00:24:13 |
| 8 | 54 |
居中:50 左,52 右,54 居中 |
| 16 | 7F 7F … |
第一行,为空:7F 表示未使用的空间 |
| 70 | 00 |
A0 在文本背后加一个方框 |
| 73 | 59 6F 75 … |
You're a jerk, Thom. |
| 124 | 00 00 00 00 |
数据块结尾,最后一个数据块可以省略 |
在文本中,88 和 98 开启和关闭斜体。F1 到 F6 以及 F8 把文本设为红、绿、黄、蓝、品红、青或橙色;F7 使其恢复白色。
时间码
时间是帧的计数,而不是时间码:每秒 25 帧时,10:00:23:00 即第 900,575 帧。文件中没有写明帧率。北欧电视为每秒 25 帧,Subtitld 按视频的帧率计数,没有视频时按 25。
顶部字幕会移到底部
没有上下位置。 至今没有人发现 Cavena 890 在哪里说明字幕位于画面较高处。Subtitld 把每条字幕都写在底部,只保留左、中或右:位于顶部或中部的字幕,再次打开时会出现在底部。
Cavena 890 还是 EBU STL?
| Cavena 890 | EBU STL | |
|---|---|---|
| 规范 | 未公开发布 | EBU Tech 3264 |
| 文件头 | 388 字节 | 1,024 字节 |
| 一条字幕 | 128 字节的数据块,每块两行 | 128 字节的数据块,112 字节文本 |
| 时间 | 帧计数 | 时间码 |
| 帧率 | 不在文件中 | 在文件头中 |
| 上下位置 | 不明 | 行号 |
Subtitld 中的 Cavena 890
- 每条字幕的文本和换行
- 斜体,用于拉丁文、希伯来文和中文
- 颜色(中文除外):取红、绿、黄、蓝、品红、青、橙和白中最接近的一种
- 文本背后的方框
- 左、中或右
- 语言,以及节目标题
- 开始和结束时间,精确到帧
- 顶部或中部的位置,会写在底部
- 粗体和下划线,目前不知道它们的代码
- 希腊文、俄文和阿拉伯文中的斜体,Subtitld 写出时不带斜体
- 码表以外的字符,会变为去掉重音的字母或 “?”
- 说话人,与原文并列的译文
- 配音、说话人的脸和颜色
如需保留这些内容,请保存为 .usfx 项目。
打开 Cavena 890 文件
Subtitld 会读取:
- 根据语言字节和字体确定的码表:拉丁文、俄文、希腊文、阿拉伯文、希伯来文或中文;
- 编号相同的数据块,作为一条字幕,各行按顺序排列;
- 斜体、颜色和方框;
- 希伯来文行中的拉丁字母和数字:文件中它们是反向保存的,Subtitld 按阅读顺序读取;
- 当所有字幕都在文件头的节目起点之后时,从该起点计算时间;否则从 0 计算;
- 按视频帧率计算的帧,没有视频时按 25。
文件头中的语言成为项目的语言,标题成为项目的标题。帧率和节目起点都会被保留,以便再次保存时保持原样。这种格式没有可供识别的标志,因此任何长度足以容纳一条字幕的 .890 文件都会被当作 Cavena 890 读取。
导出 Cavena 890
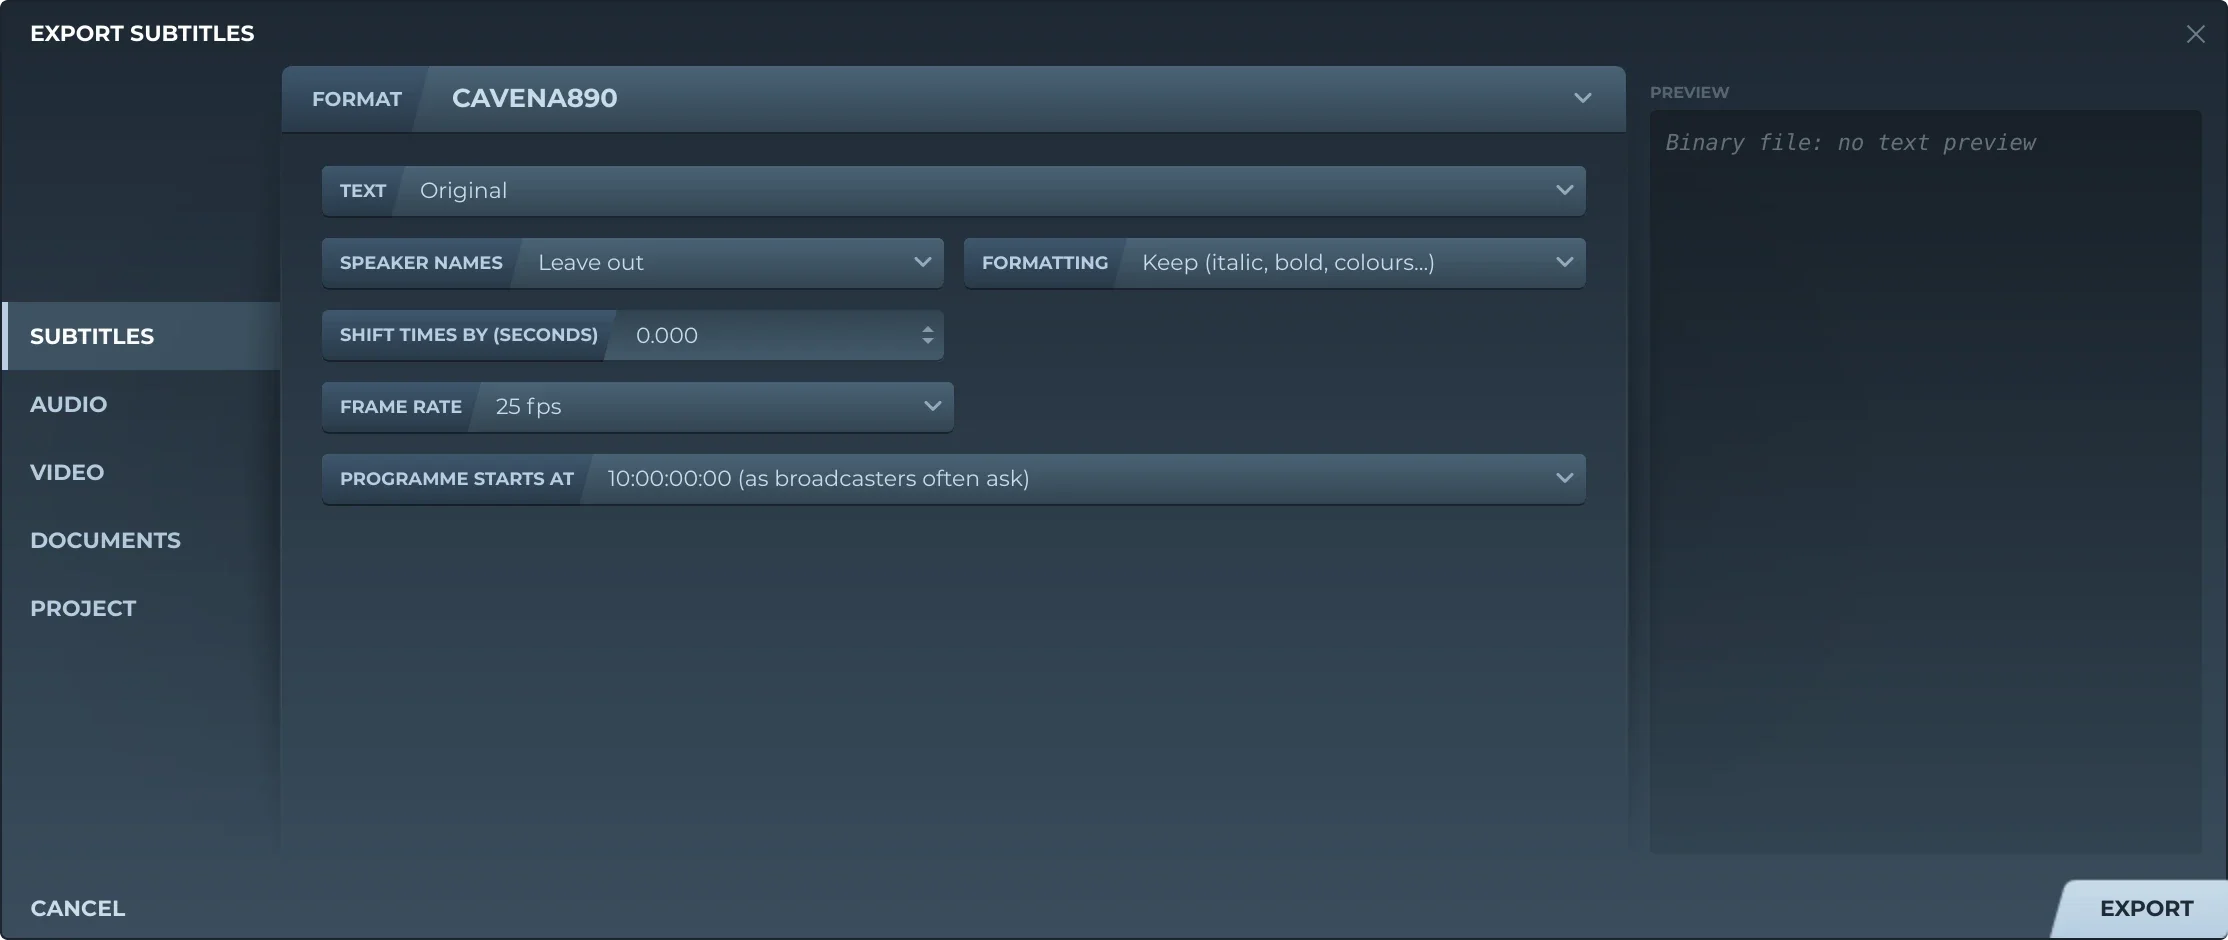
在 导出 中选择 字幕 和 CAVENA890,会提供以下选项:
- 文本原文、译文,或两者都要,译文位于原文之下。
- 说话人名字不写,或写在文本前(Thom: ……)。
- 格式保留,或去除。
- 时间偏移所有字幕整体提前或推迟相同的时长。
- 帧率除非你另选,否则为视频的帧率。文件中不会写明。
- 节目起始于00:00:00:00 或 10:00:00:00:帧从哪里开始计数。
码表为该语言的码表,或文本中的字母所需的码表。标题为项目标题,没有时则为视频名称。无论如何,文件头中的节目起点都是 10:00:00:00,与 Subtitle Edit 的写法相同;从 0 开始计算的时间位于它之前,读取程序会照原样读取。超过两行的字幕在同一编号下占用多个数据块,超过 51 字节的行会在空格处断开。
未经 Cavena 工具验证。 Subtitld 写出的内容参照 Subtitle Edit 的读写功能。它写出的文件还没有在 Cavena 自己的软件中打开过。
小知识
能读取 890 格式的字幕软件对它的另一个称呼。
斯德哥尔摩的 Edgeware 收购了 Cavena Image Products,交易于 2019 年 2 月完成。
每行文本的字节数,每个数据块两行。中文每个字符两个字节,一行可容纳 25 个字符。
相关格式
在 Subtitld 中打开它,连同视频一起,在波形上重新打轴。