
JSON 字幕与转录文本
它并非单一格式,而是许多格式的统称:语音转文字引擎、视频网站和字幕网站都用 JSON 交付字幕和转录文本,而每家的结构各不相同。Subtitld 保存自己的 JSON,采用 Whisper 的结构,并包含字幕的全部信息;它也能打开十几种其他工具写出的 JSON。
概览
| 扩展名 | .json |
|---|---|
| 媒体类型 | application/json |
| 规范 | JSON 本身:RFC 8259 和 ECMA-404。每个工具的结构各不相同。 |
| 时间精度 | Subtitld 的:秒,精确到毫秒。其他工具的:毫秒、秒、100 纳秒的刻度,或 "1.400s" 这样的文本。 |
| 文本编码 | UTF-8 |
| 样式 | Subtitld 的:文本所保留的标签。YouTube 的:粗体、斜体、下划线和颜色。其他:无。 |
| 位置 | Subtitld 的:写在文本中,形如 {\an8}。YouTube 的:窗口。哔哩哔哩的:一个位置。 |
| 说话人 | Subtitld 的 speaker;语音转文字服务会为其标注说话人 |
| 所在容器 | 无 |
Subtitld 的 JSON 结构
下面是 Subtitld 保存的一条字幕:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| 部分 | 含义 |
|---|---|
"language" |
项目的语言,以 Subtitld 的命名方式表示(en-us) |
"segments" |
字幕,按顺序排列 |
"id" |
字幕的编号,从 0 开始,与 Whisper 的编号方式相同 |
"start"、"end" |
秒 |
"text" |
字幕文本,包括其中的标签(<i>、{\an8})和换行(\n) |
"speaker"、"translations" …… |
字幕包含的其他内容:说话人、按语言分类的译文、配音 |
末尾的 "text" |
所有文本合并为一行,供只需要纯文本的工具使用。读取时不使用。 |
刻意采用 Whisper 的结构。 它就是 OpenAI 的 Whisper 所写出的结构,因此读取 Whisper 分段的工具也能读取 Subtitld 的文件;Subtitld 也能打开 Whisper 的文件,只是会忽略其解码统计信息和每个词的时间。
Subtitld 能打开的文件
每个工具的 JSON 都能通过其键来识别。Subtitld 可以打开以下几种:
| 工具 | Subtitld 从中读取的内容 |
|---|---|
| Subtitld、OpenAI 的 Whisper | 所有字段(Subtitld 的);文本和语言(Whisper 的) |
| whisper.cpp | 其分段,以及在能区分两个声道时的说话人 |
| WhisperX | 其分段和说话人 |
YouTube(.json3,由 yt-dlp 保存) |
文本、粗体、斜体、下划线、颜色和位置 |
哔哩哔哩(.bcc) |
文本和位置 |
| AssemblyAI、Deepgram、AWS Transcribe、Rev.ai、Google Speech-to-Text、Azure Speech、Speechmatics | 词、说话人和语言,转换为字幕 |
| Amara | 文本、斜体、粗体、下划线,以及位于顶部的字幕 |
如果 JSON 文件不属于以上任何一种,Subtitld 会说明原因。如果文件不是有效的 JSON,Subtitld 会指出出错的行和列。
将转录文本转换为字幕
语音转文字服务提供的是带时间的词,或是较长的话语段落。Subtitld 会把它们转换为字幕,长度受 质量检查 面板的限制:每行字符数、行数和秒数。字幕在以下位置结束:
- 说话人切换,或语音停顿超过一秒的地方;
- 句末,且下一个词会使其超出一行的时候;
- 字幕已经足够长:在它最后一个能使其大致填满的标点处结束,否则在两个词之间结束。
没有词级时间的段落,会按同样的方式分割,其时间按各部分的长度分配。
先设置限制。 字幕在文件打开时生成:在打开转录文本之前,先修改 质量检查 的限制,即可得到更长或更短的字幕。
说话人与语言
服务会为说话人编号:0、spk_1、SPEAKER_02、S3。Subtitld 会按首次发言的顺序把它们命名为 A、B、C……,与 Subtitld 自己为说话人命名的方式相同;如果文件中已经为说话人命名(Rev.ai 可以做到),则保留该名字。
项目的语言来自文件:可以是代码(en_us、pt),也可以是名称(English,Whisper 在被要求时使用这种写法),或者来自文件名,例如 video.en.json3。与项目语言相同的文件会保留项目的国家或地区:在 pt-br 项目中的 pt 仍为 pt-br。
YouTube 的 json3
这是 YouTube 播放器读取、由 yt-dlp 保存为 .json3 的内容:以毫秒为单位的文本事件,并带有用于粗体、斜体、下划线和颜色的笔,以及用于位置的窗口。自动字幕是滚动式的,一行接着一行,每行显示到下一行出现为止;Subtitld 把每一行作为一条字幕,直到下一条开始。
哔哩哔哩的 BCC
这是哔哩哔哩播放器读取的格式,也是 Subtitld 唯一会保存的另一种 JSON。
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}时间以秒为单位;content 是纯文本,其中的换行以 \n 表示。顶部的外观与哔哩哔哩自己的文件所带的相同,Subtitle Edit 也会写出这种外观。
一次只显示一条字幕。 同一时刻显示的字幕会合并为一条,文本各占一行,因此时间线上不会出现重叠。location 始终为 2,即底部居中:目前尚不知道哔哩哔哩的播放器会用它把字幕放在其他位置。
Subtitld 中的 JSON
- 每条字幕的文本、格式和位置
- 说话人、译文和配音
- 开始和结束时间,精确到毫秒
- 项目的语言
- 词的时间,以及服务对每个词的把握程度
- Whisper 解码时的统计信息
- YouTube 的字体、大小、边缘和背景
- 在 BCC 中:格式、位置,以及与原文并列的译文
如需保留属于 Subtitld 的内容,请保存为 .usfx 项目。
导出
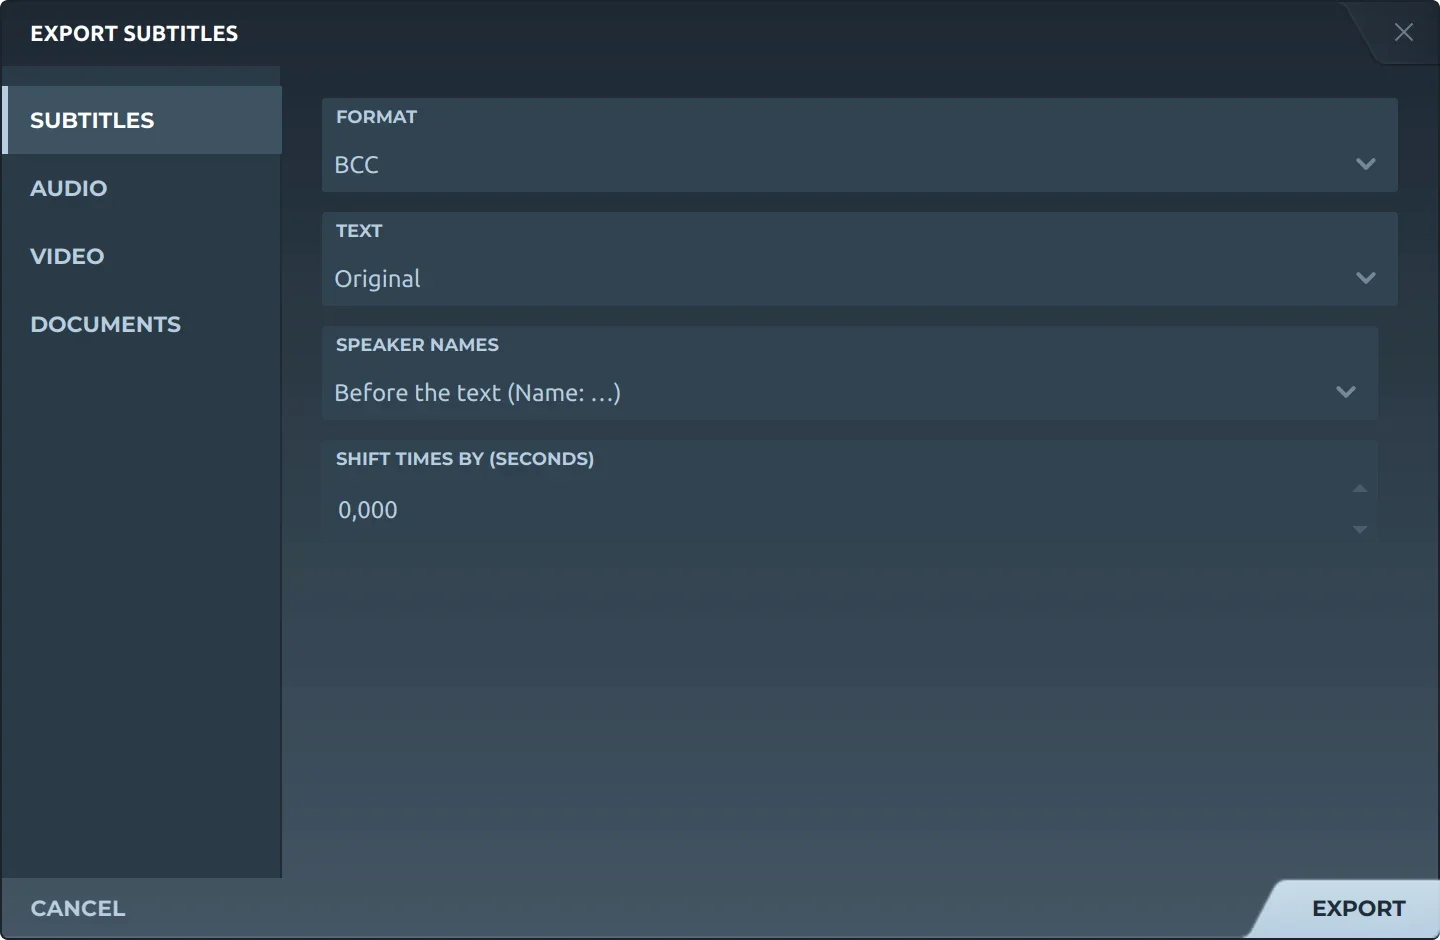
在 导出 中选择 字幕,两种格式都可以选择:
- JSONSubtitld 自己的格式:按项目原样保存,包含每条字幕和每个字段。
- BCC哔哩哔哩的格式:原文、译文,或两者都要,译文位于原文之下;说话人名字可以不写,也可以写在文本前;如果你选择,也可以进行时间偏移。
小知识
JSON 的标准,即 2017 年的 RFC 8259,规定系统之间传输的 JSON 必须使用 UTF-8。
Azure 转录文本中每秒的刻度数:它以百纳秒为单位计量时间。
对于没有说明持续时长的 json3 字幕,YouTube 播放器会显示五秒。
相关格式
在 Subtitld 中打开它,连同视频一起,在波形上重新打轴。