
JSON subtitles and transcripts
Není to jeden formát, ale mnoho: JSON je způsob, jakým enginy pro převod řeči na text, video weby a weby s titulky předávají titulky a přepisy, každý v tvaru svém. Subtitld ukládá svůj vlastní, v tvaru, který zapisuje Whisper, se vším, co titulek drží, a otevře to, co zapisuje tucet dalších nástrojů.
Na první pohled
| Přípona | .json |
|---|---|
| Typ média | application/json |
| Specifikace | Samotný JSON: RFC 8259 a ECMA-404. Tvar každého nástroje je jeho vlastní. |
| Přesnost času | Subtitldova: sekundy, na milisekundy. Jiné: milisekundy, sekundy, takty po 100 nanosekundách, nebo text jako "1.400s". |
| Kódování textu | UTF-8 |
| Styl | Subtitldův: značky, které jeho text drží. YouTube: tučné, kurzíva, podtržení a barvy. Ostatní: žádný. |
| Umístění | Subtitldovo: v textu, jako {\an8}. YouTube: okna. Bilibili: poloha. |
| Mluvčí | Subtitldův speaker; služby pro převod řeči na text označují své |
| V kontejnerech | Žádné |
Stavba Subtitldova JSON
Co Subtitld ukládá, pro jeden titulek:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Část | Co to je |
|---|---|
"language" |
Jazyk projektu, tak jak ho Subtitld pojmenovává (en-us) |
"segments" |
Titulky, v pořadí |
"id" |
Jejich číslo, od 0, jak je číslují Whisper |
"start", "end" |
Sekundy |
"text" |
Jejich text, se značkami (<i>, {\an8}) a zalomeními řádků (\n) |
"speaker", "translations" … |
Cokoli dalšího, co titulek drží: mluvčí, překlady podle jazyka, dabingy |
"text", na konci |
Veškerý text na jednom řádku, pro nástroje, které chtějí jen to. Nečte se zpět. |
Tvar Whisperu, záměrně. Je to tvar, který zapisuje Whisper od OpenAI, takže nástroje, které čtou segmenty Whisperu, čtou soubory Subtitldu, a Subtitld otevírá Whisperovy, bez statistik jeho dekódování a časů jednotlivých slov.
Co Subtitld otevírá
Každý JSON nástroje se pozná podle svých klíčů. Subtitld otevírá tyto:
| Nástroj | Co z něj Subtitld bere |
|---|---|
| Subtitld, Whisper od OpenAI | Každé pole (Subtitldovo); text a jazyk (Whisperovy) |
| whisper.cpp | Jeho segmenty, a jeho mluvčí, pokud rozlišuje dva kanály |
| WhisperX | Jeho segmenty a mluvčí |
YouTube (.json3, jak ho ukládá yt-dlp) |
Text, tučné, kurzívu, podtržení, barvy a místo |
Bilibili (.bcc) |
Text a místo |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Slova, mluvčí a jazyk, převedené na titulky |
| Amara | Text, kurzívu, tučné, podtržení a titulky nahoře |
JSON, který není žádným z nich, to oznámí. Ten, který není platný JSON, ukáže, kde se pokazil, podle řádku a sloupce.
Přepisy na titulky
Služby pro převod řeči na text předávají slova s časy, nebo dlouhé úseky řeči. Subtitld z nich dělá titulky v mezích, které povoluje panel Ověření kvality: znaky na řádek, řádky a sekundy. Titulek končí:
- tam, kde se mění mluvčí, nebo řeč utichne na víc než sekundu;
- na konci věty, když by další přetekl přes jeden řádek;
- když je plný: u posledního interpunkčního znaménka, které ho nechá dost zaplněný, jinak mezi dvěma slovy.
Úsek bez časů slov se rozdělí stejně, jeho čas podle délky částí.
Nejdřív nastavte limity. Titulky se tvoří při otevření souboru: změňte limity v Ověření kvality před otevřením přepisu, abyste dostali delší nebo kratší titulky.
Mluvčí a jazyky
Služby číslují své mluvčí: 0, spk_1, SPEAKER_02, S3. Subtitld je pojmenuje A, B, C … podle pořadí, v němž poprvé promluví, stejně jako pojmenovává mluvčí sám; mluvčího, kterého soubor pojmenuje, jako to umí Rev.ai, si ponechá jméno.
Jazyk projektu se bere ze souboru, jako kód (en_us, pt) nebo jméno (English, jak ho Whisper uchovává, když mu to řeknete), nebo jinak z názvu souboru: video.en.json3. Soubor ve vlastním jazyce projektu si ponechá zemi projektu: pt v projektu pt-br zůstane pt-br.
JSON YouTube (json3)
Co čte přehrávač YouTube a yt-dlp ukládá jako .json3: události textu v milisekundách, s pery pro tučné, kurzívu, podtržení a barvy, a okny pro místo, kde sedí. Automatické titulky se posouvají, jeden řádek za druhým, každý zobrazen až do dalšího; Subtitld z každého řádku udělá titulek, dokud nezačne další.
BCC od Bilibili
Co čte přehrávač Bilibili a druhý JSON, který Subtitld ukládá.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Časy jsou v sekundách; content je prostý text, jehož řádky jsou zalomeny znakem \n. Vzhled nahoře je ten, který nesou vlastní soubory Bilibili, a zapisuje ho i Subtitle Edit.
Jeden titulek najednou. Titulky zobrazené ve stejný okamžik se stanou jedním záznamem, jejich texty jsou řádek každý, takže časová osa nemá překryvy. location je vždy 2, dolní střed: není známo, že by přehrávač Bilibili podle něj umisťoval titulky kamkoli jinam.
JSON v Subtitldu
- Text, formátování a místo každého titulku
- Mluvčí, překlady a dabingy
- Začátek a konec po milisekundách
- Jazyk projektu
- Časy slov a to, jak si služba byla každým jistá
- Statistiky dekódování Whisperu
- Písma, velikosti, okraje a pozadí z YouTube
- U BCC: formátování, místo a překlady vedle originálu
Pro uchování toho, co je Subtitldu, použijte projekt .usfx.
Export
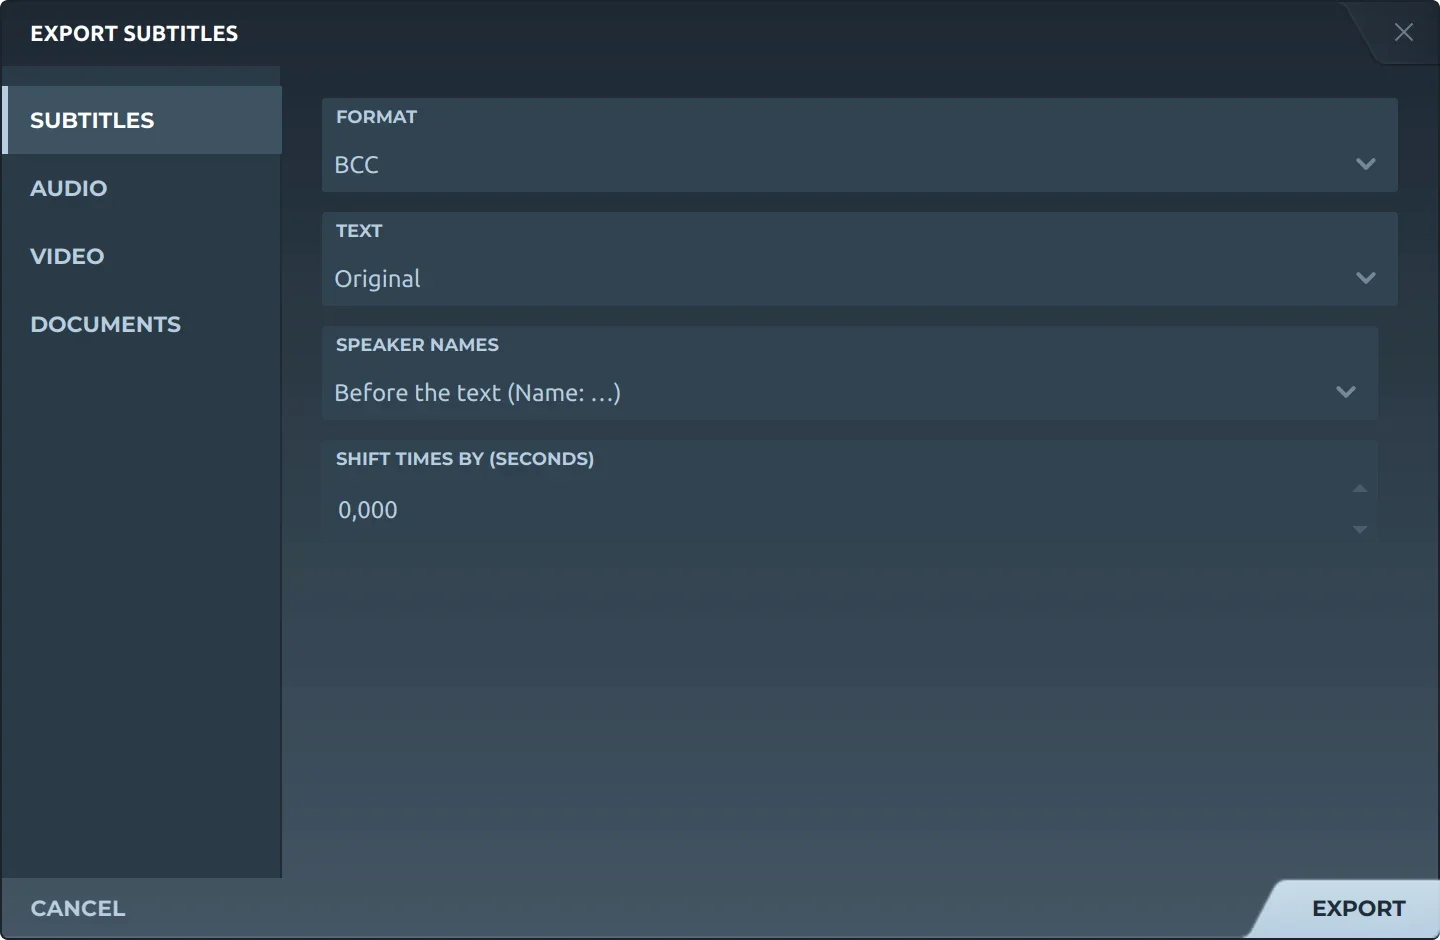
Export, pak v Titulky, nabídne obě možnosti:
- JSONSubtitldův: projekt tak, jak je, každý titulek a každé pole.
- BCCBilibili: originál, překlad, nebo obojí, překlad pod originálem; jména mluvčích vynechána, nebo před textem; časy posunuté, pokud zvolíte.
Zajímavosti
Standard JSON, RFC 8259 z roku 2017, říká, že JSON posílaný mezi systémy musí být v UTF-8.
Taktů za sekundu v přepisech Azure: čas počítá ve stovkách nanosekund.
Sekund, po které přehrávač YouTube zobrazí titulek json3, který neuvádí, jak dlouho má trvat.
Související formáty
Otevřete ho v Subtitld spolu s videem a upravte časování na zvukové vlně.