
JSON subtitles and transcripts
Non un solo formato ma molti: il JSON è il modo in cui i motori di riconoscimento vocale, i siti video e i siti di sottotitoli consegnano sottotitoli e trascrizioni, ciascuno con una forma propria. Subtitld salva la propria, nella forma che scrive Whisper, con tutto ciò che un sottotitolo contiene, e apre ciò che scrivono una dozzina di altri strumenti.
In breve
| Estensione | .json |
|---|---|
| Tipo di media | application/json |
| Specifica | Il JSON stesso: RFC 8259 ed ECMA-404. La forma di ogni strumento è propria. |
| Precisione temporale | Quella di Subtitld: secondi, al millisecondo. Altri: millisecondi, secondi, tick di 100 nanosecondi, o testo come "1.400s". |
| Codifica del testo | UTF-8 |
| Stile | Quello di Subtitld: i tag che il suo testo conserva. Quello di YouTube: grassetto, corsivo, sottolineatura e colori. Gli altri: nessuno. |
| Posizionamento | Quello di Subtitld: nel testo, come {\an8}. Quello di YouTube: finestre. Quello di Bilibili: una posizione. |
| Parlanti | Il speaker di Subtitld; i servizi di riconoscimento vocale indicano i propri |
| Nei contenitori | Nessuno |
Anatomia del JSON di Subtitld
Ciò che Subtitld salva, per un sottotitolo:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Elemento | Che cos'è |
|---|---|
"language" |
La lingua del progetto, come la nomina Subtitld (en-us) |
"segments" |
I sottotitoli, in ordine |
"id" |
Il suo numero, da 0, come Whisper li numera |
"start", "end" |
Secondi |
"text" |
Il suo testo, con i tag (<i>, {\an8}) e le righe (\n) |
"speaker", "translations" … |
Tutto ciò che il sottotitolo contiene in più: il suo parlante, le sue traduzioni per lingua, i suoi doppiaggi |
"text", alla fine |
Tutto il testo su una riga, per gli strumenti che ne vogliono solo quello. Non viene riletto. |
La forma di Whisper, di proposito. È quella che scrive il Whisper di OpenAI, quindi gli strumenti che leggono i segmenti di Whisper leggono i file di Subtitld, e Subtitld apre quelli di Whisper, lasciando fuori le statistiche della sua decodifica e i tempi di ogni parola.
Cosa apre Subtitld
Il JSON di ogni strumento dice di che tipo è dalle sue chiavi. Subtitld apre questi:
| Strumento | Cosa prende da esso |
|---|---|
| Subtitld, Whisper di OpenAI | Tutti i campi (di Subtitld); il testo e la lingua (di Whisper) |
| whisper.cpp | I suoi segmenti, e i suoi parlanti quando distingue i due canali |
| WhisperX | I suoi segmenti e i suoi parlanti |
YouTube (.json3, come lo salva yt-dlp) |
Testo, grassetto, corsivo, sottolineatura, colori e posizione |
Bilibili (.bcc) |
Testo e posizione |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Parole, parlanti e lingua, trasformati in sottotitoli |
| Amara | Testo, corsivo, grassetto, sottolineatura, e sottotitoli in alto |
Un file JSON che non è nessuno di questi lo dice. Uno che non è JSON valido indica dove sbaglia, con riga e colonna.
Trascrizioni in sottotitoli
I servizi di riconoscimento vocale consegnano parole con i loro tempi, o lunghi turni di parola. Subtitld ne ricava sottotitoli, entro i limiti che consente il pannello Verifica qualità: caratteri per riga, righe e secondi. Un sottotitolo finisce:
- dove cambia il parlante, o il parlato fa una pausa di più di un secondo;
- alla fine di una frase, quando il successivo la porterebbe oltre una riga;
- quando è pieno: al suo ultimo segno di punteggiatura che lo lascia abbastanza pieno, altrimenti tra due parole.
Un turno senza tempi di parola viene diviso allo stesso modo, con il suo tempo ripartito in base alla lunghezza delle sue parti.
Imposti prima i limiti. I sottotitoli vengono creati mentre il file si apre: cambi i limiti della Verifica qualità prima di aprire una trascrizione, per averne di più lunghi o più corti.
Parlanti e lingue
I servizi numerano i loro parlanti: 0, spk_1, SPEAKER_02, S3. Subtitld li chiama A, B, C … nell'ordine in cui parlano per la prima volta, come nomina da sé i parlanti; un parlante che un file nomina, come può fare Rev.ai, mantiene il nome.
La lingua del progetto viene dal file, come codice (en_us, pt) o come nome (English, come Whisper la conserva quando glielo si chiede), oppure dal nome del file: video.en.json3. Un file nella lingua del progetto mantiene il paese del progetto: pt in un progetto pt-br resta pt-br.
json3 di YouTube
Ciò che legge il lettore di YouTube, e yt-dlp salva come .json3: eventi di testo in millisecondi, con penne per grassetto, corsivo, sottolineatura e colori, e finestre per la loro posizione. I sottotitoli automatici scorrono, una riga dopo l'altra, ciascuna mostrata finché non ne appare un'altra; Subtitld fa di ogni riga un sottotitolo che dura fino all'inizio del successivo.
BCC di Bilibili
Ciò che legge il lettore di Bilibili, e l'unico altro JSON che Subtitld salva.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
I tempi sono in secondi; content è testo semplice, con le righe separate da \n. L'aspetto in alto è quello che portano i file propri di Bilibili, e lo scrive anche Subtitle Edit.
Un sottotitolo alla volta. I sottotitoli mostrati nello stesso momento diventano una sola voce, con i loro testi uno per riga, così la timeline non ha sovrapposizioni. location vale sempre 2, il centro in basso: non si sa che il lettore di Bilibili lo usi per posizionare i sottotitoli altrove.
JSON in Subtitld
- Testo, formattazione e posizione di ogni sottotitolo
- Parlanti, traduzioni e doppiaggi
- Inizio e fine, al millisecondo
- La lingua del progetto
- Tempi delle parole, e quanto un servizio ne fosse sicuro
- Le statistiche della decodifica di Whisper
- Caratteri, dimensioni, bordi e sfondi di YouTube
- In BCC: formattazione, posizione e traduzioni accanto all'originale
Salvi un progetto .usfx per conservare ciò che è di Subtitld.
Esportare
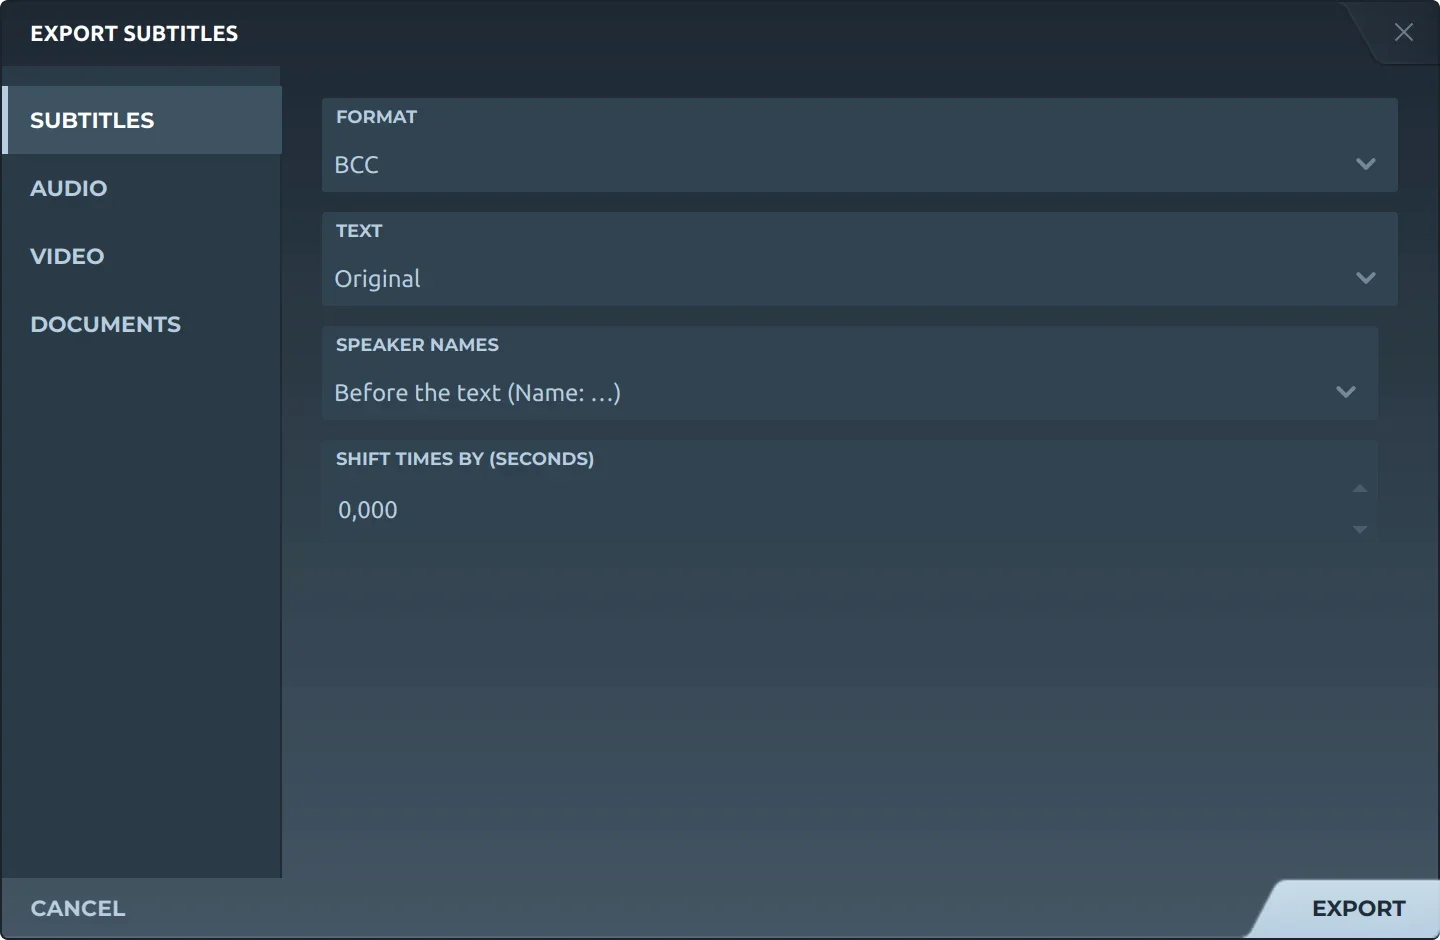
Con Esporta, poi Sottotitoli, si offrono entrambi:
- JSONQuello di Subtitld: il progetto così com'è, ogni sottotitolo e ogni campo.
- BCCQuello di Bilibili: l'originale, una traduzione, o entrambi, con la traduzione sotto; i nomi dei parlanti omessi o prima del testo; i tempi spostati, se lo sceglie.
Curiosità
Lo standard del JSON, la RFC 8259 del 2017, stabilisce che il JSON inviato tra sistemi deve essere in UTF-8.
Tick al secondo nelle trascrizioni di Azure: il servizio conta il tempo in centinaia di nanosecondi.
Secondi che il lettore di YouTube mostra per un sottotitolo json3 che non dice per quanto durerà.
Formati correlati
Lo apra in Subtitld con il video e lo sincronizzi sulla forma d'onda.