
字幕と書き起こしのJSON
1つのフォーマットではなく、多くのフォーマットの総称です。音声認識エンジン、動画サイト、字幕サイトは、字幕や書き起こしをJSONで渡します。それぞれ独自の構造を持ちます。Subtitldは、字幕が持つすべての情報を含む独自の形式で保存します。その形式はWhisperが書く形です。また、十数種のツールが書くJSONを開くこともできます。
概要
| 拡張子 | .json |
|---|---|
| メディアタイプ | application/json |
| 仕様 | JSONそのもの。RFC 8259とECMA-404。構造はツールごとに異なります。 |
| 時間の精度 | Subtitldのもの: 秒単位(ミリ秒まで)。他のもの: ミリ秒、秒、100ナノ秒単位のティック、または "1.400s" のようなテキスト |
| 文字コード | UTF-8 |
| 装飾 | Subtitldのもの: テキストが保持するタグ。YouTubeのもの: 太字、斜体、下線、色。その他: なし |
| 配置 | Subtitldのもの: テキスト内の {\an8}。YouTubeのもの: ウィンドウ。Bilibiliのもの: 位置 |
| 話者 | Subtitldのもの: speaker。音声認識サービスは、それぞれのラベルを付けます |
| コンテナ内 | なし |
SubtitldのJSONの構成
Subtitldが保存する内容を、1つの字幕について示します。
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| 項目 | 内容 |
|---|---|
"language" |
プロジェクトの言語。Subtitldでの表記(en-us) |
"segments" |
字幕。順番どおり |
"id" |
番号。Whisperと同じく0から |
"start"、"end" |
秒 |
"text" |
テキスト。タグ(<i>、{\an8})と改行(\n)を含みます |
"speaker"、"translations" など |
字幕が持つその他の情報。話者、言語ごとの翻訳、吹き替え |
末尾の "text" |
すべてのテキストを1行にしたもの。それだけを必要とするツール向けです。読み戻されることはありません |
意図的にWhisperの構造にしています。 OpenAIのWhisperが書く形式なので、Whisperのセグメントを読むツールは、Subtitldのファイルも読めます。また、Subtitldは、Whisperのファイルを開けます。ただし、デコードの統計と単語ごとの時刻は除きます。
Subtitldが開くもの
各ツールのJSONは、そのキーによって種類が分かります。Subtitldが開けるのは次のものです。
| ツール | Subtitldが取り込む内容 |
|---|---|
| Subtitld、OpenAIのWhisper | すべての項目(Subtitldのもの)。テキストと言語(Whisperのもの) |
| whisper.cpp | セグメント。2つのチャンネルを区別している場合は話者 |
| WhisperX | セグメントと話者 |
YouTube(.json3、yt-dlpが保存する形式) |
テキスト、太字、斜体、下線、色、位置 |
Bilibili(.bcc) |
テキストと位置 |
| AssemblyAI、Deepgram、AWS Transcribe、Rev.ai、Google Speech-to-Text、Azure Speech、Speechmatics | 単語、話者、言語を字幕に変換 |
| Amara | テキスト、斜体、太字、下線、上部に表示される字幕 |
どれでもないJSONファイルは、その旨を表示します。有効なJSONでないファイルは、エラーの行と列を示します。
書き起こしを字幕へ
音声認識サービスは、単語とその時刻、または長い発話のまとまりを渡します。Subtitldは、品質チェックパネルで許可された範囲内で、それらを字幕にします。ここでの範囲は、1行あたりの文字数、行数、秒数です。字幕は次の場所で終わります。
- 話者が変わったとき、または発話が1秒を超えて途切れたとき。
- 文末で、次の文を加えると1行を超えてしまうとき。
- いっぱいになったとき: ほどよく埋まる最後の句読点、なければ2語の間。
単語の時刻がない発話は、同じ方法で分けます。その時刻は、各部分の長さに応じて割り振られます。
先に上限を設定してください。 字幕は、ファイルを開くときに作られます。書き起こしを開く前に品質チェックの上限を変えると、字幕を長くも短くもできます。
話者と言語
サービスは話者に 0、spk_1、SPEAKER_02、S3 などの番号を付けます。Subtitldは、それらを話し始めた順にA、B、C…と呼び、話者の名前は自分で付けます。ファイルが名前を持つ場合(Rev.aiはそれができます)、その名前を保持します。
プロジェクトの言語は、ファイルから読み取ります。コード(en_us、pt)、または名前(Whisperが指定されたときに保持する English)として書かれています。ない場合は、ファイル名から判断します(video.en.json3)。プロジェクトと同じ言語のファイルは、プロジェクトの国の指定を保持します。たとえば pt-br のプロジェクトでは、pt は pt-br になります。
YouTubeのjson3
YouTubeのプレーヤーが読み、yt-dlpが .json3 として保存する形式です。ミリ秒単位のテキストのイベントからなり、太字、斜体、下線、色のペン、そして表示位置のウィンドウを持ちます。自動キャプションは、行が次々と切り替わり、それぞれ次の行が現れるまで表示されます。Subtitldは、次の行が始まるまで、各行を1つの字幕にします。
BilibiliのBCC
Bilibiliのプレーヤーが読む形式で、Subtitldが保存するもう1つのJSONです。
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}時刻は秒です。content はプレーンテキストで、改行は \n で示されます。上部の見た目は、Bilibiliの公式ファイルが持つものと同じです。Subtitle Editも同様に書き出します。
一度に1つの字幕。 同時に表示される字幕は、1つのエントリにまとめられ、テキストは1行ずつになります。そのため、タイムラインに重なりは生じません。location は常に2、つまり下中央です。Bilibiliのプレーヤーが、それ以外の場所に字幕を配置するために使うことは知られていません。
Subtitldでの JSON
- 各字幕のテキスト、装飾、位置
- 話者、翻訳、吹き替え
- 開始と終了(ミリ秒単位)
- プロジェクトの言語
- 単語ごとの時刻と、サービスがそれぞれにどれだけ確信を持っていたか
- Whisperのデコードの統計
- YouTubeのフォント、サイズ、縁、背景
- BCCでは、装飾、位置、原文の横に並べた翻訳
Subtitld独自の情報を残すには、.usfx プロジェクトとして保存してください。
書き出し
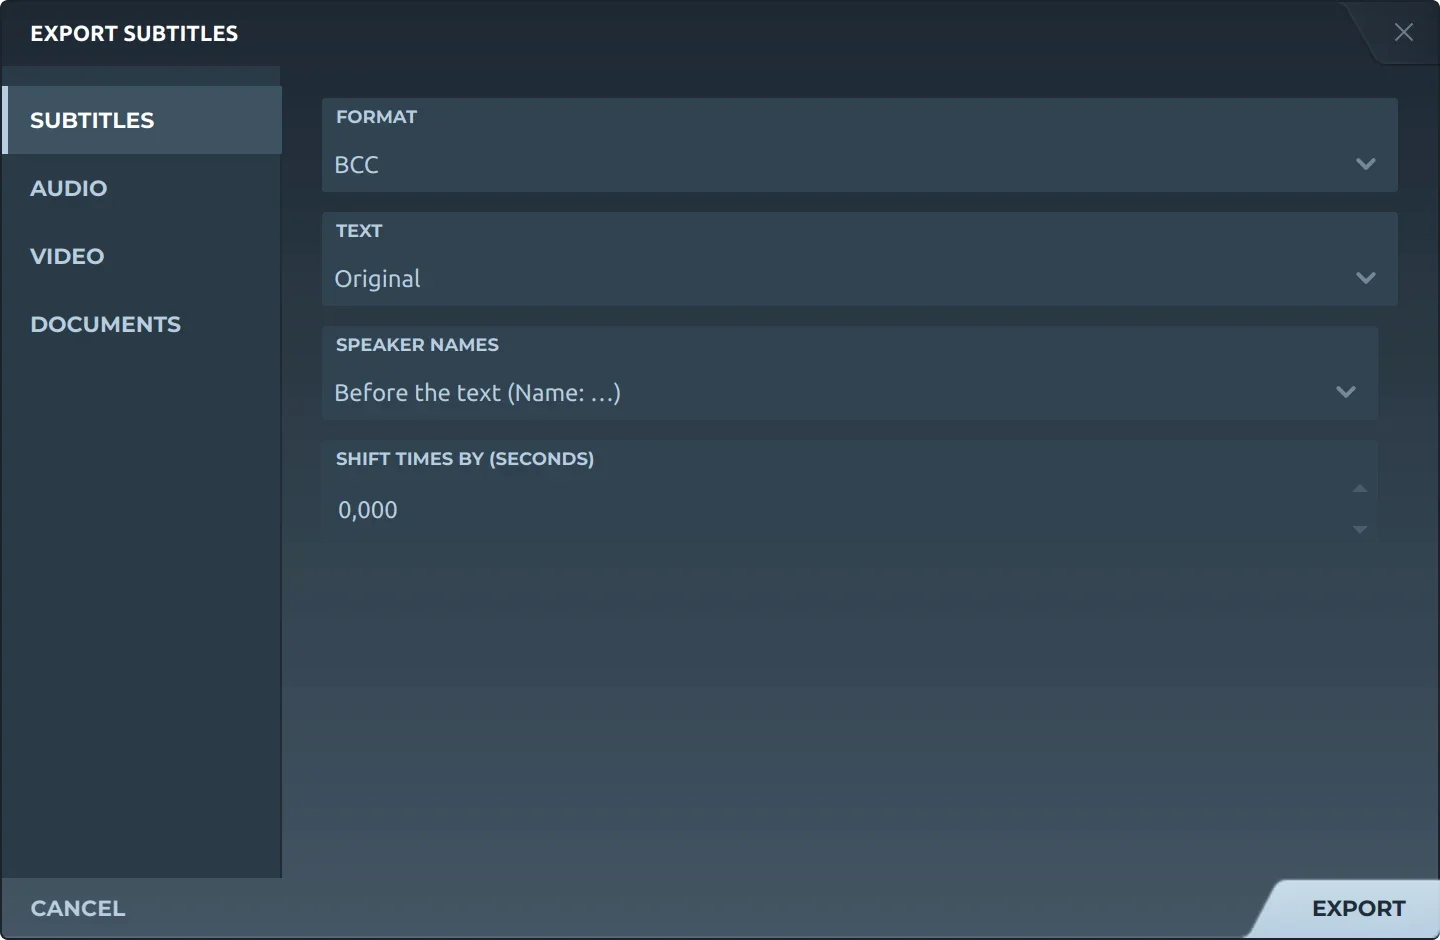
エクスポート、字幕の順に選ぶと、次の2つを選べます。
- JSONSubtitld独自のもの。プロジェクトをそのままの状態で、すべての字幕とすべての項目を保存します。
- BCCBilibiliのもの。原文、翻訳、または両方(翻訳は下に表示)。話者名は省略するか、テキストの前に書きます。必要に応じて時刻をずらすこともできます。
豆知識
JSONの標準であるRFC 8259(2017年)は、システム間で送るJSONはUTF-8でなければならないと定めています。
Azureの書き起こしで1秒あたりのティック数です。時刻を100ナノ秒単位で数えます。
YouTubeのプレーヤーは、表示時間を指定していないjson3のキャプションを5秒間表示します。
関連する形式
Subtitld で動画と一緒に開き、波形上でタイミングを調整しましょう。