
JSON subtitles and transcripts
Geen formaat maar veel: JSON is hoe spraakherkenningsengines, videosites en ondertitelsites ondertitels en transcripties overdragen, elk in een eigen vorm. Subtitld bewaart zijn eigen vorm, die van Whisper, met alles wat een ondertitel bevat, en opent wat een dozijn andere tools schrijven.
In één oogopslag
| Extensie | .json |
|---|---|
| Mediatype | application/json |
| Specificatie | JSON zelf: RFC 8259 en ECMA-404. De vorm van elke tool is eigen. |
| Tijdsprecisie | Die van Subtitld: seconden, tot de milliseconde. Andere: milliseconden, seconden, ticks van 100 nanoseconden, of tekst zoals "1.400s". |
| Tekstcodering | UTF-8 |
| Opmaak | Die van Subtitld: de tags die de tekst bewaart. Die van YouTube: vet, cursief, onderstreping en kleuren. De rest: geen. |
| Positionering | Die van Subtitld: in de tekst, als {\an8}. Die van YouTube: vensters. Die van Bilibili: een locatie. |
| Sprekers | De speaker van Subtitld; spraakherkenningsdiensten labelen die van hen |
| In containers | Geen |
Opbouw van de JSON van Subtitld
Wat Subtitld bewaart, voor één ondertitel:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Onderdeel | Wat het is |
|---|---|
"language" |
De taal van het project, zoals Subtitld hem noemt (en-us) |
"segments" |
De ondertitels, in volgorde |
"id" |
Zijn nummer, vanaf 0, zoals Whisper ze nummert |
"start", "end" |
Seconden |
"text" |
Zijn tekst, met zijn tags (<i>, {\an8}) en regeleindes (\n) |
"speaker", "translations" … |
Wat de ondertitel verder bevat: zijn spreker, zijn vertalingen per taal, zijn nasynchronisaties |
"text", aan het eind |
Alle tekst op één regel, voor tools die alleen dat willen. Wordt niet teruggelezen. |
De vorm van Whisper, bewust. Het is wat OpenAI's Whisper schrijft, dus tools die de segmenten van Whisper lezen, lezen de bestanden van Subtitld, en Subtitld opent die van Whisper, zonder de statistieken van zijn decodering en de tijden van elk woord.
Wat Subtitld opent
Het JSON-bestand van elke tool zegt met zijn sleutels welke het is. Subtitld opent deze:
| Tool | Wat Subtitld eruit haalt |
|---|---|
| Subtitld, OpenAI's Whisper | Elk veld (van Subtitld); de tekst en de taal (van Whisper) |
| whisper.cpp | Zijn segmenten, en zijn sprekers als het de twee kanalen kan onderscheiden |
| WhisperX | Zijn segmenten en sprekers |
YouTube (.json3, zoals yt-dlp het opslaat) |
Tekst, vet, cursief, onderstreping, kleuren en plaats |
Bilibili (.bcc) |
Tekst en plaats |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Woorden, sprekers en taal, omgezet in ondertitels |
| Amara | Tekst, cursief, vet, onderstreping, en ondertitels bovenaan |
Een JSON-bestand dat geen van deze is, zegt dat. Een dat geen geldige JSON is, zegt waar het misgaat, met regel en kolom.
Transcripties naar ondertitels
Spraakherkenningsdiensten leveren woorden met hun tijden, of lange beurten van spraak. Subtitld maakt er ondertitels van, zolang de limieten van het paneel Kwaliteitscheck dat toestaan: tekens per regel, regels, en seconden. Een ondertitel eindigt:
- waar de spreker wisselt, of de spraak meer dan een seconde pauzeert;
- aan het eind van een zin, wanneer de volgende hem boven één regel zou brengen;
- wanneer hij vol is: bij het laatste leesteken dat hem redelijk vol laat, anders tussen twee woorden.
Een beurt zonder woordtijden wordt op dezelfde manier verdeeld, met zijn tijd naar de lengte van zijn delen.
Stel de limieten eerst in. Ondertitels worden gemaakt terwijl het bestand opent: wijzig de limieten van de Kwaliteitscheck voordat u een transcriptie opent, om langere of kortere ondertitels te krijgen.
Sprekers en talen
Diensten nummeren hun sprekers: 0, spk_1, SPEAKER_02, S3. Subtitld noemt ze A, B, C … in de volgorde waarin ze voor het eerst spreken, zoals het sprekers zelf benoemt; een spreker die een bestand bij naam noemt, zoals Rev.ai kan, behoudt die naam.
De taal van het project komt uit het bestand, als code (en_us, pt) of naam (English, zoals Whisper die bewaart als het dat wordt gevraagd), of anders uit de naam van het bestand: video.en.json3. Een bestand in de eigen taal van het project behoudt het land van het project: pt in een pt-br-project blijft pt-br.
JSON van YouTube (json3)
Wat de speler van YouTube leest, en yt-dlp opslaat als .json3: gebeurtenissen van tekst in milliseconden, met pennen voor vet, cursief, onderstreping en kleuren, en vensters voor waar ze staan. Automatische ondertitels rollen, de ene regel na de andere, elk getoond tot de volgende verschijnt; Subtitld maakt van elke regel een ondertitel tot de volgende begint.
Bilibili's BCC
Wat de speler van Bilibili leest, en de andere JSON die Subtitld bewaart.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Tijden zijn seconden; content is platte tekst, met regels gebroken door \n. Het uiterlijk bovenaan is dat wat de eigen bestanden van Bilibili dragen, en Subtitle Edit schrijft het ook.
Eén ondertitel tegelijk. Ondertitels die tegelijk worden getoond, worden één item, hun teksten een regel per stuk, zodat de tijdlijn geen overlappingen heeft. location is altijd 2, het midden onderaan: van de speler van Bilibili is niet bekend dat die er ondertitels mee elders plaatst.
JSON in Subtitld
- Elke tekst van een ondertitel, opmaak en plaats
- Sprekers, vertalingen en nasynchronisaties
- Begin en eind, tot de milliseconde
- De taal van het project
- Tijden van woorden, en hoe zeker een dienst van elk was
- De statistieken van Whisper van zijn decodering
- Lettertypen, groottes, randen en achtergronden van YouTube
- In BCC: opmaak, plaats, en vertalingen naast het origineel
Sla een .usfx-project op om te bewaren wat van Subtitld is.
Exporteren
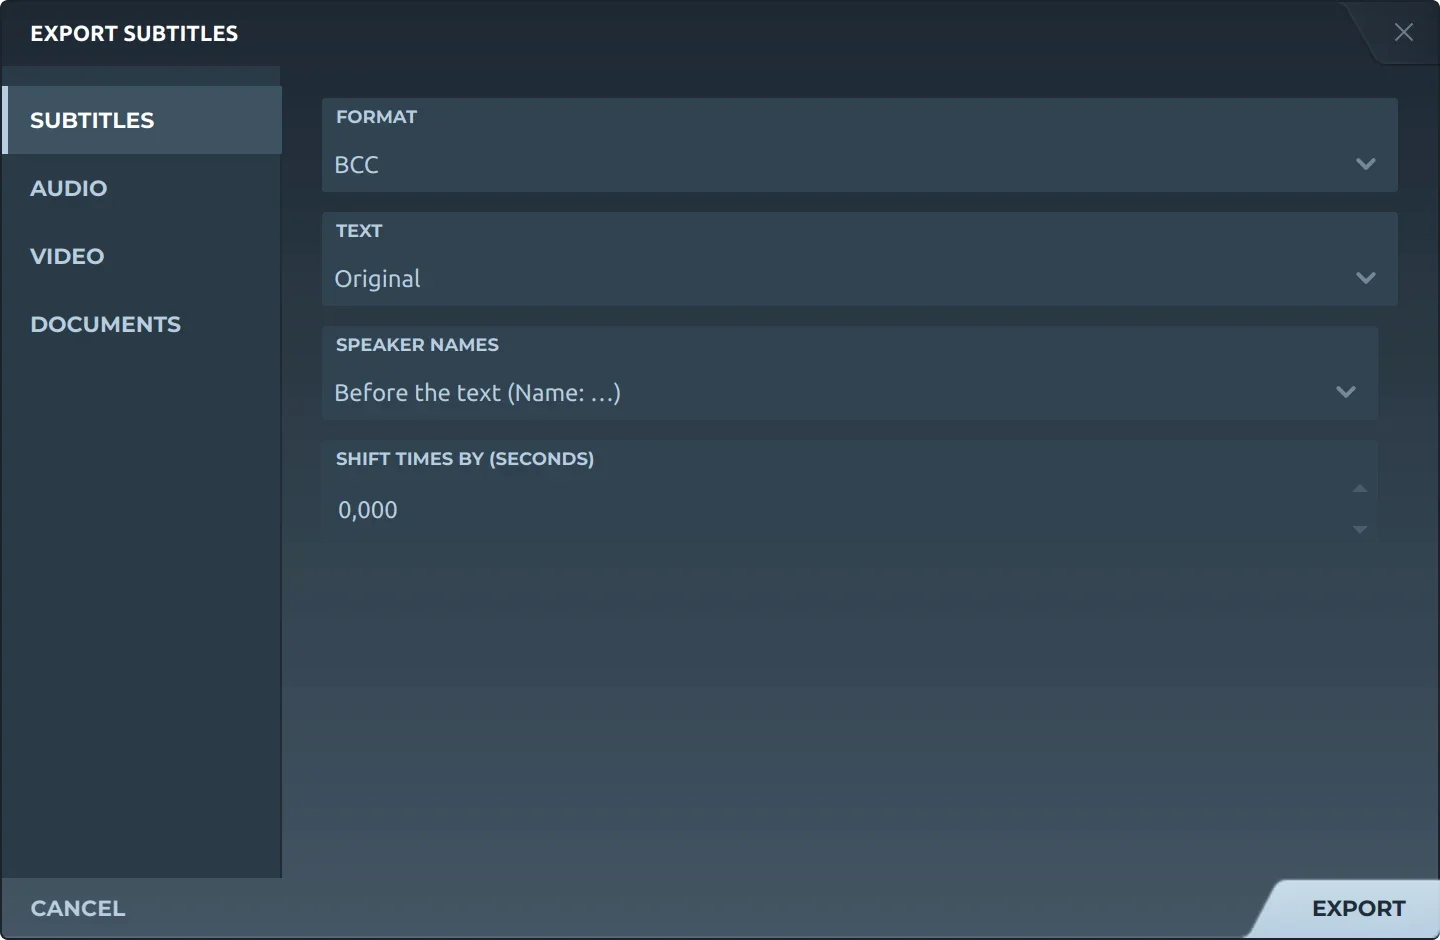
Bij Exporteren, dan Ondertitels, biedt u beide:
- JSONDie van Subtitld: het project zoals het is, elke ondertitel en elk veld.
- BCCDie van Bilibili: het origineel, een vertaling, of beide, de vertaling eronder; sprekernamen weggelaten of voor de tekst; tijden verschoven als u kiest.
Wetenswaardigheden
De standaard van JSON, RFC 8259 uit 2017, schrijft voor dat JSON die tussen systemen wordt verstuurd UTF-8 moet zijn.
Ticks per seconde in de transcripties van Azure: het telt tijd in honderden nanoseconden.
Seconden die de speler van YouTube toont bij een json3-ondertitel die niet zegt hoe lang hij duurt.
Verwante formaten
Open het in Subtitld met de video en stel de timing bij op de golfvorm.