
Legendas e transcrições em JSON
Não um formato, mas muitos: o JSON é como os motores de reconhecimento de fala, os sites de vídeo e os sites de legendas entregam legendas e transcrições, cada um em um formato próprio. O Subtitld grava o seu, no formato que o Whisper escreve, com tudo o que uma legenda guarda, e abre o que uma dúzia de outras ferramentas escrevem.
Resumo
| Extensão | .json |
|---|---|
| Tipo de mídia | application/json |
| Especificação | O próprio JSON: RFC 8259 e ECMA-404. O formato de cada ferramenta é o seu. |
| Precisão do tempo | A do Subtitld: segundos, até o milissegundo. Outras: milissegundos, segundos, ticks de 100 nanossegundos, ou texto como "1.400s". |
| Codificação do texto | UTF-8 |
| Estilo | O do Subtitld: as marcações que o texto mantém. O do YouTube: negrito, itálico, sublinhado e cores. Os demais: nenhum. |
| Posicionamento | O do Subtitld: no texto, como {\an8}. O do YouTube: janelas. O do Bilibili: uma localização. |
| Falantes | O speaker do Subtitld; os serviços de reconhecimento de fala rotulam os seus |
| Em contêineres | Nenhum |
Estrutura do JSON do Subtitld
O que o Subtitld grava, para uma legenda:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Parte | O que é |
|---|---|
"language" |
O idioma do projeto, como o Subtitld o nomeia (en-us) |
"segments" |
As legendas, em ordem |
"id" |
Seu número, a partir de 0, como o Whisper os numera |
"start", "end" |
Segundos |
"text" |
Seu texto, com as marcações (<i>, {\an8}) e quebras de linha (\n) |
"speaker", "translations" … |
O que mais a legenda guarda: seu falante, suas traduções por idioma, suas dublagens |
"text", no fim |
Todo o texto em uma linha só, para ferramentas que querem só isso. Não é lido de volta. |
O formato do Whisper, de propósito. É o que o Whisper da OpenAI escreve, então as ferramentas que leem os segmentos do Whisper leem os arquivos do Subtitld, e o Subtitld abre os do Whisper, deixando de lado as estatísticas da decodificação e os tempos de cada palavra.
O que o Subtitld abre
O JSON de cada ferramenta diz de qual é pelas suas chaves. O Subtitld abre estes:
| Ferramenta | O que o Subtitld aproveita |
|---|---|
| Subtitld, Whisper da OpenAI | Todos os campos (do Subtitld); o texto e o idioma (do Whisper) |
| whisper.cpp | Seus segmentos, e seus falantes quando ele distingue os dois canais |
| WhisperX | Seus segmentos e falantes |
YouTube (.json3, como o yt-dlp o salva) |
Texto, negrito, itálico, sublinhado, cores e lugar |
Bilibili (.bcc) |
Texto e lugar |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Palavras, falantes e idioma, transformados em legendas |
| Amara | Texto, itálico, negrito, sublinhado, e legendas no topo |
Um arquivo JSON que não é nenhum desses diz isso. Um que não é JSON válido diz onde está o erro, por linha e coluna.
Transcrições em legendas
Os serviços de reconhecimento de fala entregam palavras com seus tempos, ou longos trechos de fala. O Subtitld os transforma em legendas, dentro do que o painel Verificação de qualidade permitir: caracteres por linha, linhas e segundos. Uma legenda termina:
- onde o falante muda, ou a fala faz uma pausa de mais de um segundo;
- no fim de uma frase, quando a próxima a levaria além de uma linha;
- quando está cheia: no último sinal de pontuação que a deixa razoavelmente cheia, senão entre duas palavras.
Um trecho sem tempos de palavra é dividido do mesmo jeito, com seu tempo proporcional ao tamanho das partes.
Defina os limites primeiro. As legendas são feitas enquanto o arquivo é aberto: altere os limites da Verificação de qualidade antes de abrir uma transcrição para obter legendas mais longas ou mais curtas.
Falantes e idiomas
Os serviços numeram seus falantes: 0, spk_1, SPEAKER_02, S3. O Subtitld os chama de A, B, C … na ordem em que falam pela primeira vez, como nomeia os falantes por conta própria; um falante que o arquivo nomeia, como o Rev.ai pode fazer, mantém o nome.
O idioma do projeto vem do arquivo, como um código (en_us, pt) ou um nome (English, como o Whisper o guarda quando pedido), ou então do nome do arquivo: video.en.json3. Um arquivo no idioma do projeto mantém o país do projeto: pt em um projeto pt-br continua pt-br.
O json3 do YouTube
O que o player do YouTube lê, e o yt-dlp salva como .json3: eventos de texto em milissegundos, com canetas para negrito, itálico, sublinhado e cores, e janelas para o lugar em que aparecem. Legendas automáticas rolam, uma linha depois da outra, cada uma mostrada até a próxima aparecer; o Subtitld faz de cada linha uma legenda, até a próxima começar.
O BCC do Bilibili
O que o player do Bilibili lê, e o único outro JSON que o Subtitld grava.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Os tempos são em segundos; content é texto simples, com as linhas separadas por \n. A aparência no topo é a que os próprios arquivos do Bilibili trazem, e o Subtitle Edit também grava.
Uma legenda de cada vez. Legendas mostradas no mesmo momento viram uma entrada só, com os textos em uma linha cada, então a linha do tempo não tem sobreposições. location é sempre 2, o centro inferior: não se sabe que o player do Bilibili use outro valor para posicionar legendas.
JSON no Subtitld
- Texto, formatação e lugar de cada legenda
- Falantes, traduções e dublagens
- Início e fim, até o milissegundo
- O idioma do projeto
- Tempos de palavras, e quão certo um serviço estava de cada uma
- As estatísticas de decodificação do Whisper
- Fontes, tamanhos, bordas e fundos do YouTube
- No BCC: formatação, lugar e traduções ao lado do original
Salve um projeto .usfx para manter o que é do Subtitld.
Exportando
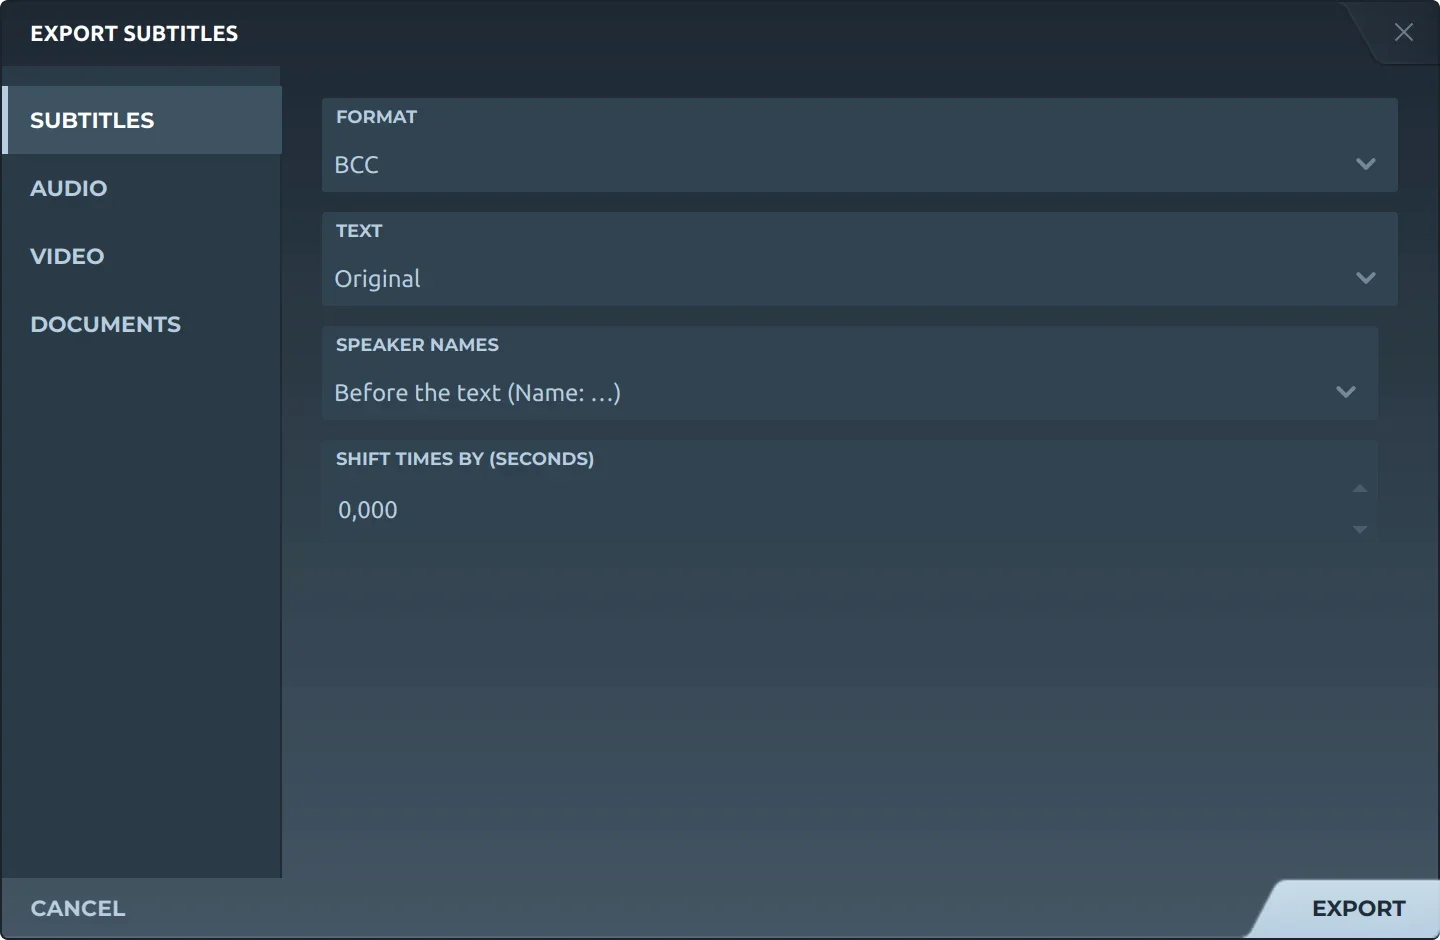
Exportar, depois Legendas, oferece os dois:
- JSONO do Subtitld: o projeto como está, cada legenda e cada campo.
- BCCO do Bilibili: o original, uma tradução ou os dois, com a tradução embaixo; nomes dos falantes omitidos ou antes do texto; tempos deslocados, se você quiser.
Curiosidades
O padrão do JSON, a RFC 8259 de 2017, diz que o JSON enviado entre sistemas deve ser UTF-8.
Ticks por segundo nas transcrições da Azure: ela conta o tempo em centenas de nanossegundos.
Segundos que o player do YouTube mostra uma legenda json3 que não diz por quanto tempo dura.
Formatos relacionados
Abra no Subtitld com o vídeo e reajuste-o na forma de onda.