
Субтитри й транскрипти JSON
Не один формат, а багато: JSON — це спосіб, яким сервіси мовлення в текст, відеосайти й сайти субтитрів передають субтитри й транскрипти, кожен у власній формі. Subtitld зберігає свій формат — у формі, яку записує Whisper, з усім, що має субтитр, — і відкриває те, що записують десятки інших інструментів.
Коротко
| Розширення | .json |
|---|---|
| Тип медіа | application/json |
| Специфікація | Сам JSON: RFC 8259 і ECMA-404. Форма кожного інструменту — його власна. |
| Точність часу | Subtitld: секунди, до мілісекунди. Інші: мілісекунди, секунди, такти по 100 наносекунд або текст на кшталт "1.400s". |
| Кодування тексту | UTF-8 |
| Оформлення | Subtitld: теги, які зберігає його текст. YouTube: жирний, курсив, підкреслення і кольори. Решта: немає. |
| Розміщення | Subtitld: у тексті, як {\an8}. YouTube: вікна. Bilibili: положення. |
| Мовці | Поле speaker у Subtitld; сервіси мовлення в текст позначають своїх |
| У контейнерах | Немає |
Будова JSON у Subtitld
Те, що Subtitld зберігає для одного субтитра:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Фрагмент | Що це |
|---|---|
"language" |
Мова проєкту, як її називає Subtitld (en-us) |
"segments" |
Субтитри, за порядком |
"id" |
Його номер, з 0, як нумерує їх Whisper |
"start", "end" |
Секунди |
"text" |
Його текст із тегами (<i>, {\an8}) і переносами рядків (\n) |
"speaker", "translations" … |
Усе інше, що має субтитр: його мовець, переклади за мовами, дубляжі |
"text", наприкінці |
Увесь текст в одному рядку, для інструментів, яким потрібен лише він. Не читається назад. |
Форма Whisper, навмисно. Це та форма, яку записує Whisper від OpenAI, тож інструменти, які читають сегменти Whisper, читають файли Subtitld, а Subtitld відкриває файли Whisper, пропускаючи статистику його декодування та час кожного слова.
Що відкриває Subtitld
Кожен JSON інструмента говорить, чий він, за своїми ключами. Subtitld відкриває ці:
| Інструмент | Що Subtitld бере з нього |
|---|---|
| Subtitld, Whisper від OpenAI | Кожне поле (Subtitld); текст і мову (Whisper) |
| whisper.cpp | Його сегменти, а також мовців, коли він розрізняє два канали |
| WhisperX | Його сегменти та мовців |
YouTube (.json3, як його зберігає yt-dlp) |
Текст, жирний, курсив, підкреслення, кольори та місце |
Bilibili (.bcc) |
Текст і місце |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Слова, мовців і мову, перетворені на субтитри |
| Amara | Текст, курсив, жирний, підкреслення і субтитри вгорі |
JSON-файл, який не є жодним із них, так і повідомляє. Файл, що не є дійсним JSON, вказує, де саме помилка, за рядком і стовпцем.
Транскрипти в субтитри
Сервіси мовлення в текст віддають слова з їхнім часом або довгі фрагменти мовлення. Subtitld робить із них субтитри в межах, які дозволяє панель Перевірка якості: символи на рядок, рядки й секунди. Субтитр закінчується:
- там, де змінюється мовець або мовлення паузує більш ніж на секунду;
- наприкінці речення, коли наступне перевищило б один рядок;
- коли він заповнений: на останньому розділовому знаку, який лишає його досить заповненим, інакше між двома словами.
Фрагмент без часу слів ділиться так само, а його час — за довжиною частин.
Спершу налаштуйте межі. Субтитри створюються під час відкриття файлу, тож змініть межі в Перевірка якості до відкриття транскрипта, щоб отримати довші або коротші субтитри.
Мовці та мови
Сервіси нумерують своїх мовців: 0, spk_1, SPEAKER_02, S3. Subtitld називає їх A, B, C … у порядку, в якому вони вперше говорять, так само як називає мовців сама; мовця, якого файл називає на ім’я, як це може Rev.ai, Subtitld залишає з іменем.
Мова проєкту береться з файлу як код (en_us, pt) або назва (English, як її зберігає Whisper, якщо його так налаштувати), а інакше — з назви файлу: video.en.json3. Файл мовою проєкту зберігає країну проєкту: pt у проєкті pt-br лишається pt-br.
JSON YouTube (json3)
Те, що читає плеєр YouTube і що зберігає yt-dlp як .json3: події тексту в мілісекундах, із пером для жирного, курсиву, підкреслення і кольорів, і вікнами для того, де вони стоять. Автоматичні субтитри прокручуються, рядок за рядком, кожен показується до появи наступного; Subtitld робить із кожного рядка субтитр, доки не почнеться наступний.
BCC від Bilibili
Те, що читає плеєр Bilibili, і другий JSON, який Subtitld зберігає.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Час задано в секундах; content — простий текст, рядки розділено \n. Вигляд угорі такий самий, як у власних файлів Bilibili, і його також записує Subtitle Edit.
Один субтитр за раз. Субтитри, що показуються в один момент, стають одним записом, а їхні тексти — окремими рядками, тож на таймлайні немає перекриттів. location завжди 2, тобто низ по центру: відомо, що плеєр Bilibili не використовує його для розміщення субтитрів деінде.
JSON у Subtitld
- Текст, оформлення і місце кожного субтитра
- Мовці, переклади й дубляжі
- Початок і кінець до мілісекунди
- Мова проєкту
- Часи слів і те, наскільки сервіс упевнений у кожному
- Статистика декодування Whisper
- Шрифти, розміри, краї та фони з YouTube
- У BCC: оформлення, місце й переклади поруч з оригіналом
Щоб зберегти те, що належить Subtitld, збережіть проєкт .usfx.
Експорт
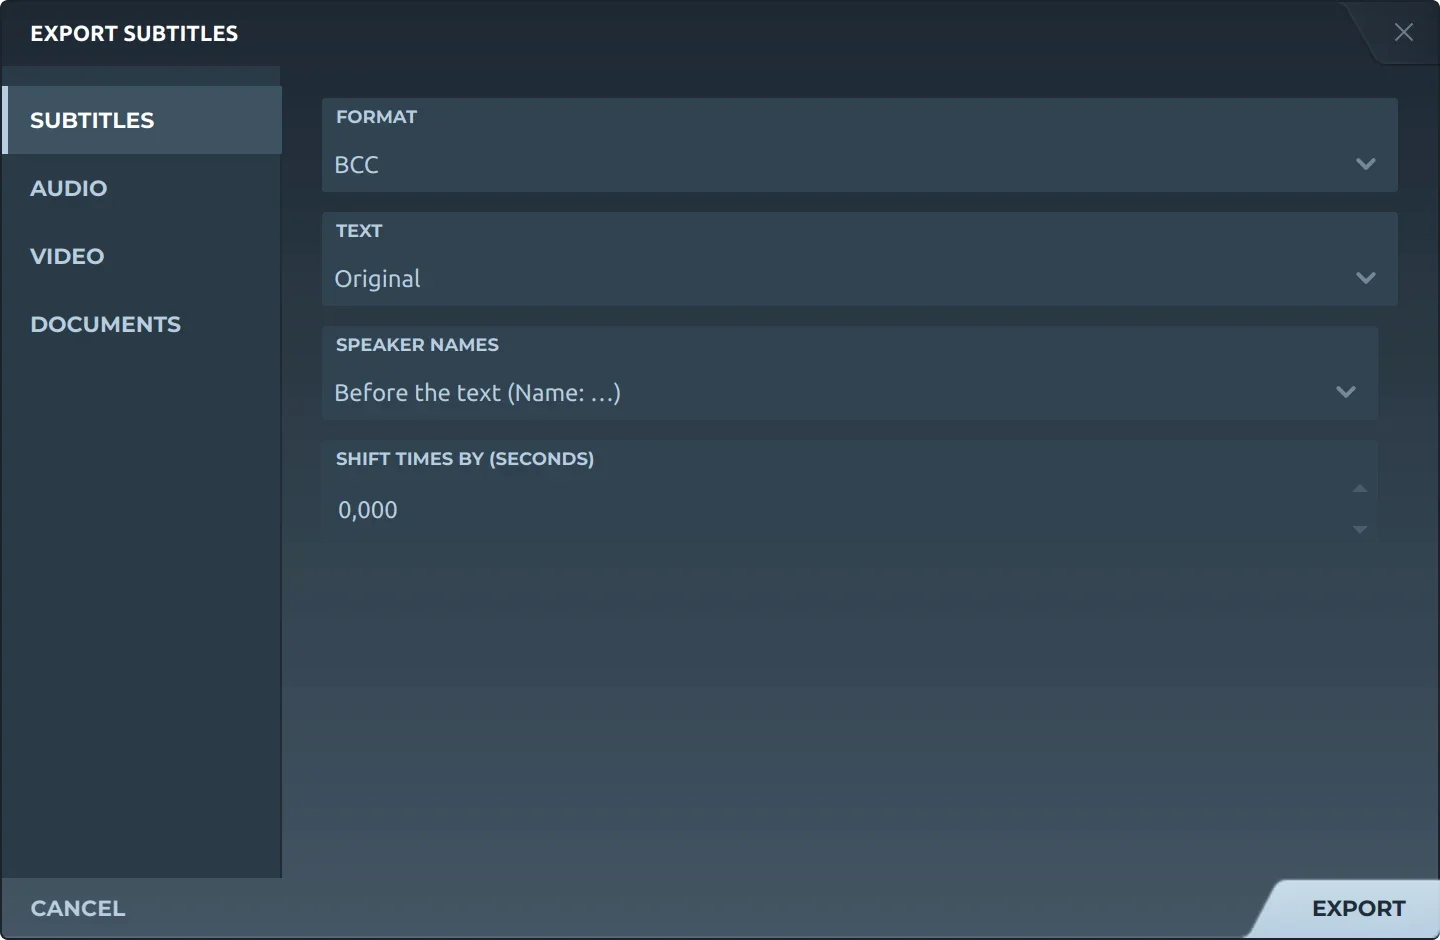
Експорт, далі Субтитри, пропонує обидва:
- JSONФормат Subtitld: проєкт як є, кожен субтитр і кожне поле.
- BCCФормат Bilibili: оригінал, переклад або обидва, переклад унизу; імена мовців не вказувати або писати перед текстом; час зсунути, якщо ви так вибрали.
Цікаве
Стандарт JSON, RFC 8259 від 2017 року, вимагає, щоб JSON, який надсилається між системами, був у UTF-8.
Такти за секунду в транскриптах Azure: там час рахують у сотнях наносекунд.
Секунди, які плеєр YouTube показує субтитр json3, якщо той не каже, як довго він триває.
Пов'язані формати
Відкрийте його в Subtitld разом із відео та вирівняйте за хвилею.