
JSON-субтитры и транскрипты
Не один формат, а много: JSON — способ, которым движки распознавания речи, видеосайты и сайты субтитров передают субтитры и транскрипты, каждый в своем виде. Subtitld сохраняет свой JSON в виде, который пишет Whisper, со всем, что есть у субтитра, и открывает то, что пишут десятки других инструментов.
Коротко
| Расширение | .json |
|---|---|
| Тип медиа | application/json |
| Спецификация | Сам JSON: RFC 8259 и ECMA-404. У каждого инструмента свой вид. |
| Точность времени | Subtitld: секунды, до миллисекунды. Другие: миллисекунды, секунды, тики по 100 наносекунд или текст вида "1.400s". |
| Кодировка текста | UTF-8 |
| Оформление | Subtitld: теги, которые сохраняет текст. YouTube: полужирный, курсив, подчеркивание и цвета. Остальные: нет. |
| Расположение | Subtitld: в тексте, как {\an8}. YouTube: окна. Bilibili: положение. |
| Говорящие | speaker в Subtitld; сервисы распознавания речи помечают своих |
| В контейнерах | Нет |
Анатомия JSON в Subtitld
Что Subtitld сохраняет для одного субтитра:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Часть | Что это |
|---|---|
"language" |
Язык проекта, как его называет Subtitld (en-us) |
"segments" |
Субтитры, по порядку |
"id" |
Его номер, с 0, как их нумерует Whisper |
"start", "end" |
Секунды |
"text" |
Его текст с тегами (<i>, {\an8}) и переносами строк (\n) |
"speaker", "translations" … |
Все остальное, что есть у субтитра: говорящий, его переводы по языкам, его озвучка |
"text" в конце |
Весь текст в одну строку, для инструментов, которым нужен только он. Не читается обратно. |
Вид Whisper, намеренно. Это тот вид, который пишет Whisper от OpenAI, поэтому инструменты, читающие сегменты Whisper, читают файлы Subtitld, а Subtitld открывает файлы Whisper, не учитывая статистику его декодирования и времена отдельных слов.
Что открывает Subtitld
Каждый JSON инструмента сообщает, какой он, по своим ключам. Subtitld открывает такие:
| Инструмент | Что Subtitld берет из него |
|---|---|
| Subtitld, OpenAI Whisper | Все поля (Subtitld); текст и язык (Whisper) |
| whisper.cpp | Его сегменты и говорящих, когда он различает два канала |
| WhisperX | Его сегменты и говорящих |
YouTube (.json3, как его сохраняет yt-dlp) |
Текст, полужирный, курсив, подчеркивание, цвета и место |
Bilibili (.bcc) |
Текст и место |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Слова, говорящих и язык, превращенные в субтитры |
| Amara | Текст, курсив, полужирный, подчеркивание, а также субтитры вверху |
JSON-файл, который не относится ни к одному из них, так и сообщает. Тот, что не является допустимым JSON, указывает, где он ломается, по строке и столбцу.
Транскрипты в субтитры
Сервисы распознавания речи передают слова с их временами или длинные реплики. Subtitld делает из них субтитры, в пределах, которые позволяет панель Проверка качества: символы в строке, строки и секунды. Субтитр заканчивается:
- там, где меняется говорящий или речь делает паузу больше секунды;
- в конце предложения, когда следующее перенесло бы его за одну строку;
- когда он заполнен: на последнем знаке препинания, который оставляет его достаточно заполненным, иначе между двумя словами.
Реплика без времени слов делится так же: ее время распределяется по длине частей.
Сначала задайте пределы. Субтитры создаются при открытии файла: измените пределы в Проверка качества до открытия транскрипта, чтобы получить более длинные или короткие субтитры.
Говорящие и языки
Сервисы нумеруют говорящих: 0, spk_1, SPEAKER_02, S3. Subtitld называет их A, B, C … в порядке, в котором они впервые заговорили, как сама называет говорящих; говорящий, которому файл дает имя, как может Rev.ai, сохраняет его.
Язык проекта берется из файла как код (en_us, pt) или название (English, как Whisper его хранит, если его об этом попросить), либо из имени файла: video.en.json3. Файл на языке проекта сохраняет страну проекта: pt в проекте pt-br остается pt-br.
JSON3 YouTube
То, что читает плеер YouTube и что yt-dlp сохраняет как .json3: события текста в миллисекундах, с перьями для полужирного, курсива, подчеркивания и цветов и окнами для места. Автоматические субтитры прокручиваются: строка за строкой, каждая показана до появления следующей. Subtitld делает каждую строку субтитром до начала следующей.
BCC Bilibili
То, что читает плеер Bilibili, и единственный другой JSON, который сохраняет Subtitld.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Времена в секундах; content — простой текст, строки которого разделены \n. Вид сверху — тот, что несут собственные файлы Bilibili и что также пишет Subtitle Edit.
По одному субтитру за раз. Субтитры, показанные в один момент, становятся одной записью, их тексты — по строке на каждый, поэтому на таймлайне нет наложений. location всегда равен 2, нижнему центру: плеер Bilibili, насколько известно, не использует его, чтобы ставить субтитры в другом месте.
JSON в Subtitld
- Текст, оформление и место каждого субтитра
- Говорящие, переводы и озвучка
- Начало и конец, до миллисекунды
- Язык проекта
- Времена слов и то, насколько уверен был сервис в каждом
- Статистика декодирования Whisper
- Шрифты, размеры, обводки и фоны YouTube
- В BCC: оформление, место и переводы рядом с оригиналом
Сохраните проект .usfx, чтобы сохранить то, что принадлежит Subtitld.
Экспорт
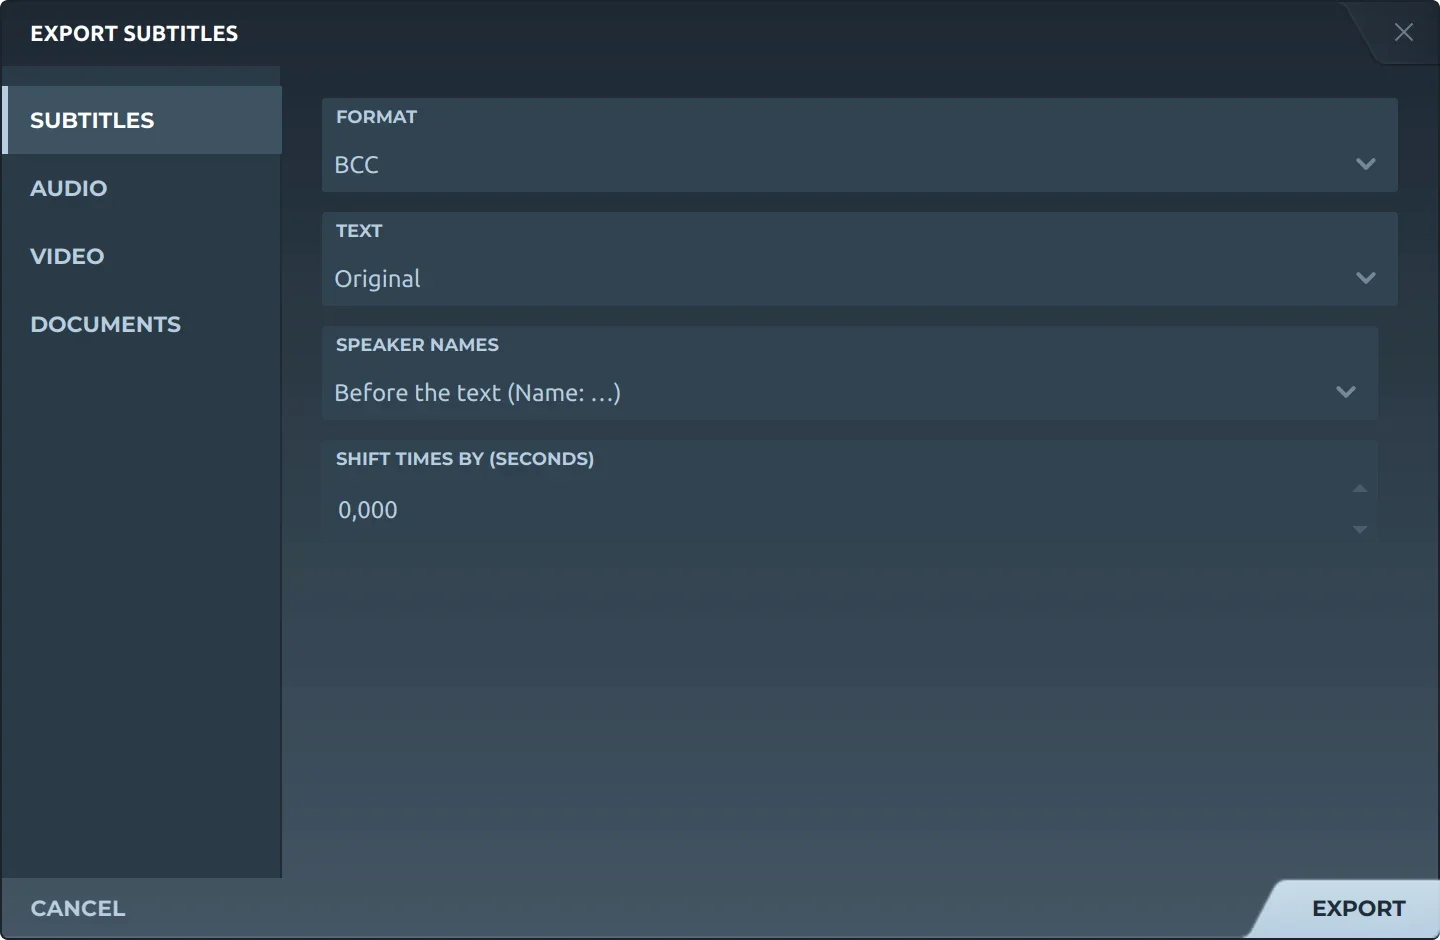
Экспорт, затем Субтитры, предлагает оба варианта:
- JSONJSON Subtitld: проект как есть, каждый субтитр и каждое поле.
- BCCBilibili: оригинал, перевод или оба, перевод ниже; имена говорящих опущены или перед текстом; времена сдвинуты, если вы выберете.
Любопытное
Стандарт JSON, RFC 8259 от 2017 года, требует, чтобы JSON, передаваемый между системами, был в UTF-8.
Тиков в секунду в транскриптах Azure: там время считается сотнями наносекунд.
Секунд, в течение которых плеер YouTube показывает json3-субтитр, не сообщающий, как долго он длится.
Похожие форматы
Откройте его в Subtitld вместе с видео и поправьте тайминг по осциллограмме.