
Subtítulos y transcripciones en JSON
No es un solo formato, sino muchos: JSON es la forma en que los motores de voz a texto, los sitios de vídeo y los sitios de subtítulos entregan subtítulos y transcripciones, cada uno con una forma propia. Subtitld guarda los suyos con la forma que escribe Whisper, con todo lo que contiene un subtítulo, y abre lo que escriben una docena de otras herramientas.
De un vistazo
| Extensión | .json |
|---|---|
| Tipo de medio | application/json |
| Especificación | El propio JSON: RFC 8259 y ECMA-404. La forma de cada herramienta es suya. |
| Precisión temporal | La de Subtitld: segundos, al milisegundo. Otras: milisegundos, segundos, tics de 100 nanosegundos, o texto como "1.400s". |
| Codificación del texto | UTF-8 |
| Estilo | El de Subtitld: las etiquetas que conserva su texto. El de YouTube: negrita, cursiva, subrayado y colores. El resto: ninguno. |
| Posición | El de Subtitld: en el texto, como {\an8}. El de YouTube: ventanas. El de Bilibili: una ubicación. |
| Hablantes | El speaker de Subtitld; los servicios de voz a texto etiquetan los suyos |
| En contenedores | Ninguno |
Anatomía del JSON de Subtitld
Lo que guarda Subtitld para un subtítulo:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Pieza | Qué es |
|---|---|
"language" |
El idioma del proyecto, como lo nombra Subtitld (en-us) |
"segments" |
Los subtítulos, en orden |
"id" |
Su número, desde 0, como lo numera Whisper |
"start", "end" |
Segundos |
"text" |
Su texto, con sus etiquetas (<i>, {\an8}) y saltos de línea (\n) |
"speaker", "translations" … |
Lo demás que contiene el subtítulo: su hablante, sus traducciones por idioma, sus doblajes |
"text", al final |
Todo el texto en una línea, para las herramientas que solo quieren eso. No se vuelve a leer. |
La forma de Whisper, a propósito. Es la que escribe Whisper de OpenAI, así que las herramientas que leen los segmentos de Whisper leen los archivos de Subtitld, y Subtitld abre los de Whisper, dejando fuera las estadísticas de su decodificación y los tiempos de cada palabra.
Qué abre Subtitld
Cada JSON de herramienta indica cuál es por sus claves. Subtitld abre estos:
| Herramienta | Qué toma Subtitld de ella |
|---|---|
| Subtitld, Whisper de OpenAI | Cada campo (los de Subtitld); el texto y el idioma (los de Whisper) |
| whisper.cpp | Sus segmentos, y sus hablantes cuando distingue los dos canales |
| WhisperX | Sus segmentos y sus hablantes |
YouTube (.json3, como lo guarda yt-dlp) |
Texto, negrita, cursiva, subrayado, colores y lugar |
Bilibili (.bcc) |
Texto y lugar |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Palabras, hablantes e idioma, convertidos en subtítulos |
| Amara | Texto, cursiva, negrita, subrayado, y subtítulos arriba |
Un JSON que no es ninguno de ellos lo dice. Uno que no es JSON válido indica dónde falla, por línea y columna.
Transcripciones a subtítulos
Los servicios de voz a texto entregan palabras con sus tiempos, o turnos largos de habla. Subtitld los convierte en subtítulos, según lo permita el panel Comprobación de calidad: caracteres por línea, líneas y segundos. Un subtítulo termina:
- donde cambia el hablante, o el habla hace una pausa de más de un segundo;
- al final de una frase, cuando la siguiente lo llevaría a pasar de una línea;
- cuando está lleno: en su último signo de puntuación que lo deja bastante lleno, y si no, entre dos palabras.
Un turno sin tiempos de palabra se reparte igual, con su tiempo proporcional a la longitud de sus partes.
Ajusta primero los límites. Los subtítulos se crean al abrir el archivo: cambia los límites de Comprobación de calidad antes de abrir una transcripción para obtener subtítulos más largos o más cortos.
Hablantes e idiomas
Los servicios numeran a sus hablantes: 0, spk_1, SPEAKER_02, S3. Subtitld los llama A, B, C … en el orden en que hablan por primera vez, como nombra a los hablantes por sí mismo; un hablante que el archivo nombra, como puede hacer Rev.ai, conserva ese nombre.
El idioma del proyecto viene del archivo, como código (en_us, pt) o como nombre (English, como lo guarda Whisper si se le indica), o si no, del nombre del archivo: video.en.json3. Un archivo en el idioma del proyecto conserva el país del proyecto: pt en un proyecto pt-br sigue siendo pt-br.
El json3 de YouTube
Lo que lee el reproductor de YouTube, y guarda yt-dlp como .json3: eventos de texto en milisegundos, con plumas para la negrita, la cursiva, el subrayado y los colores, y ventanas para el lugar donde aparecen. Los subtítulos automáticos se desplazan, una línea tras otra, y cada una se muestra hasta que aparece la siguiente; Subtitld convierte cada línea en un subtítulo hasta que empieza la siguiente.
El BCC de Bilibili
Lo que lee el reproductor de Bilibili, y el otro JSON que guarda Subtitld.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Los tiempos están en segundos; content es texto plano, con sus líneas separadas por \n. El aspecto de arriba es el que llevan los archivos propios de Bilibili, y también lo escribe Subtitle Edit.
Un subtítulo cada vez. Los subtítulos que se muestran en el mismo momento se convierten en una sola entrada, con sus textos en líneas aparte, así que la línea de tiempo no tiene solapamientos. location es siempre 2, el centro inferior: no se sabe que el reproductor de Bilibili lo use para colocar los subtítulos en otro lugar.
JSON en Subtitld
- El texto, el formato y el lugar de cada subtítulo
- Hablantes, traducciones y doblajes
- Inicio y fin, al milisegundo
- El idioma del proyecto
- Tiempos de palabra, y cuánta seguridad tenía un servicio en cada una
- Las estadísticas de decodificación de Whisper
- Tipografías, tamaños, bordes y fondos de YouTube
- En BCC: formato, lugar y traducciones junto al original
Guarda un proyecto .usfx para conservar lo que es de Subtitld.
Exportar
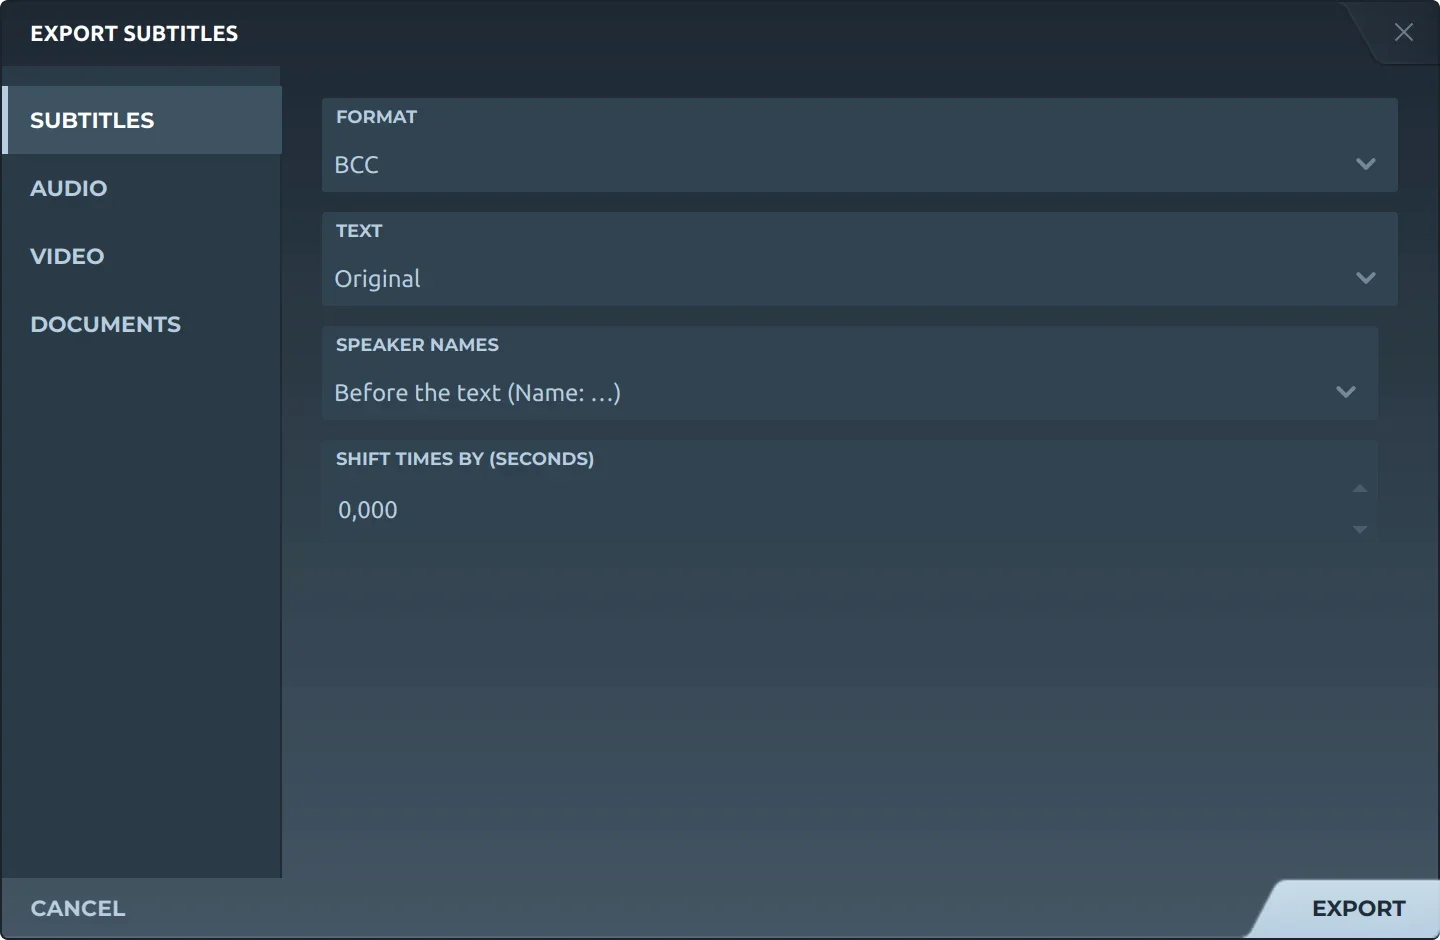
Exportar, y luego Subtítulos, ofrece ambos:
- JSONEl de Subtitld: el proyecto tal como está, cada subtítulo y cada campo.
- BCCEl de Bilibili: el original, una traducción o ambos, con la traducción debajo; nombres de hablantes omitidos o antes del texto; tiempos desplazados si lo eliges.
Curiosidades
El estándar de JSON, RFC 8259 de 2017, dice que el JSON enviado entre sistemas debe ser UTF-8.
Tics por segundo en las transcripciones de Azure: cuenta el tiempo en centenas de nanosegundos.
Segundos que muestra el reproductor de YouTube para un subtítulo json3 que no indica cuánto dura.
Formatos relacionados
Ábrelo en Subtitld con el vídeo y reajústalo sobre la forma de onda.