
Sous-titres et transcriptions JSON
Pas un seul format mais plusieurs : le JSON est le moyen par lequel les moteurs de reconnaissance vocale, les sites vidéo et les sites de sous-titres transmettent sous-titres et transcriptions, chacun dans une forme qui lui est propre. Subtitld enregistre les siens, dans la forme qu'écrit Whisper, avec tout ce que contient un sous-titre, et ouvre ce qu'une douzaine d'autres outils écrivent.
En bref
| Extension | .json |
|---|---|
| Type de média | application/json |
| Spécification | Le JSON lui-même : RFC 8259 et ECMA-404. La forme de chaque outil lui est propre. |
| Précision temporelle | Celle de Subtitld : secondes, à la milliseconde. Les autres : millisecondes, secondes, tics de 100 nanosecondes, ou du texte comme "1.400s". |
| Encodage du texte | UTF-8 |
| Style | Celui de Subtitld : les balises que conserve son texte. Celui de YouTube : gras, italique, soulignement et couleurs. Les autres : aucun. |
| Positionnement | Celui de Subtitld : dans le texte, sous la forme {\an8}. Celui de YouTube : des fenêtres. Celui de Bilibili : un emplacement. |
| Locuteurs | Le speaker de Subtitld ; les services de reconnaissance vocale nomment les leurs |
| Dans les conteneurs | Aucun |
Anatomie du JSON de Subtitld
Ce qu'enregistre Subtitld, pour un sous-titre :
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Élément | Ce que c'est |
|---|---|
"language" |
La langue du projet, telle que la nomme Subtitld (en-us) |
"segments" |
Les sous-titres, dans l'ordre |
"id" |
Son numéro, à partir de 0, comme le numérote Whisper |
"start", "end" |
Secondes |
"text" |
Son texte, avec ses balises (<i>, {\an8}) et ses sauts de ligne (\n) |
"speaker", "translations" … |
Tout le reste que contient le sous-titre : son locuteur, ses traductions par langue, ses doublages |
"text", à la fin |
Tout le texte sur une seule ligne, pour les outils qui n'en veulent que ça. Non relu. |
La forme de Whisper, délibérément. C'est celle qu'écrit le Whisper d'OpenAI, si bien que les outils qui lisent les segments de Whisper lisent les fichiers de Subtitld, et que Subtitld ouvre ceux de Whisper, en laissant de côté les statistiques de son décodage et les temps de chaque mot.
Ce que Subtitld ouvre
Le JSON de chaque outil indique lui-même lequel il est, par ses clés. Subtitld ouvre ceux-ci :
| Outil | Ce que Subtitld en prend |
|---|---|
| Subtitld, Whisper d'OpenAI | Chaque champ (ceux de Subtitld) ; le texte et la langue (ceux de Whisper) |
| whisper.cpp | Ses segments, et ses locuteurs lorsqu'il distingue les deux canaux |
| WhisperX | Ses segments et ses locuteurs |
YouTube (.json3, tel qu'yt-dlp l'enregistre) |
Texte, gras, italique, soulignement, couleurs et emplacement |
Bilibili (.bcc) |
Texte et emplacement |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Les mots, les locuteurs et la langue, transformés en sous-titres |
| Amara | Texte, italique, gras, soulignement, et sous-titres en haut |
Un fichier JSON qui n'est aucun de ceux-là le dit. Un fichier qui n'est pas du JSON valide indique où il se trompe, par ligne et colonne.
Transcriptions en sous-titres
Les services de reconnaissance vocale livrent des mots avec leurs temps, ou de longs tours de parole. Subtitld en fait des sous-titres, dans les limites de son panneau Vérification qualité : caractères par ligne, lignes et secondes. Un sous-titre se termine :
- lorsque le locuteur change, ou que la parole marque une pause de plus d'une seconde ;
- à la fin d'une phrase, lorsque le suivant la ferait dépasser une ligne ;
- lorsqu'il est plein : à sa dernière ponctuation qui le laisse assez plein, sinon entre deux mots.
Un tour de parole sans temps de mots est réparti de la même façon, son temps étant partagé selon la longueur de ses parties.
Réglez d'abord les limites. Les sous-titres sont créés à l'ouverture du fichier : modifiez les limites de Vérification qualité avant d'ouvrir une transcription pour obtenir des sous-titres plus longs ou plus courts.
Locuteurs et langues
Les services numérotent leurs locuteurs : 0, spk_1, SPEAKER_02, S3. Subtitld les appelle A, B, C … dans l'ordre où ils prennent la parole pour la première fois, comme il nomme lui-même ses locuteurs ; un locuteur qu'un fichier nomme, comme peut le faire Rev.ai, garde son nom.
La langue du projet vient du fichier, sous forme de code (en_us, pt) ou de nom (English, tel que Whisper le garde lorsqu'on le lui demande), ou sinon du nom du fichier : video.en.json3. Un fichier dans la langue du projet garde le pays du projet : pt dans un projet pt-br reste pt-br.
JSON de YouTube
Ce que lit le lecteur de YouTube, et qu'yt-dlp enregistre au format .json3 : des événements de texte en millisecondes, avec des plumes pour le gras, l'italique, le soulignement et les couleurs, et des fenêtres pour l'endroit où ils s'affichent. Les sous-titres automatiques défilent, une ligne après l'autre, chacune affichée jusqu'à l'apparition de la suivante ; Subtitld fait de chaque ligne un sous-titre jusqu'au début de la suivante.
BCC de Bilibili
Ce que lit le lecteur de Bilibili, et l'autre JSON que Subtitld enregistre.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Les temps sont en secondes ; content est du texte brut, ses lignes séparées par \n. L'aspect en haut est celui que portent les fichiers propres à Bilibili, et que Subtitle Edit écrit aussi.
Un sous-titre à la fois. Les sous-titres affichés au même moment deviennent une seule entrée, leurs textes une ligne chacun, si bien que la chronologie n'a aucun chevauchement. location vaut toujours 2, le centre bas : le lecteur de Bilibili n'est pas connu pour s'en servir afin de placer les sous-titres ailleurs.
JSON dans Subtitld
- Le texte, la mise en forme et l'emplacement de chaque sous-titre
- Les locuteurs, les traductions et les doublages
- Début et fin, à la milliseconde
- La langue du projet
- Les temps de chaque mot, et le degré de certitude d'un service pour chacun
- Les statistiques de décodage de Whisper
- Polices, tailles, bordures et arrière-plans de YouTube
- En BCC : mise en forme, emplacement, et traductions à côté de l'original
Enregistrez un projet .usfx pour conserver ce qui est propre à Subtitld.
Exporter
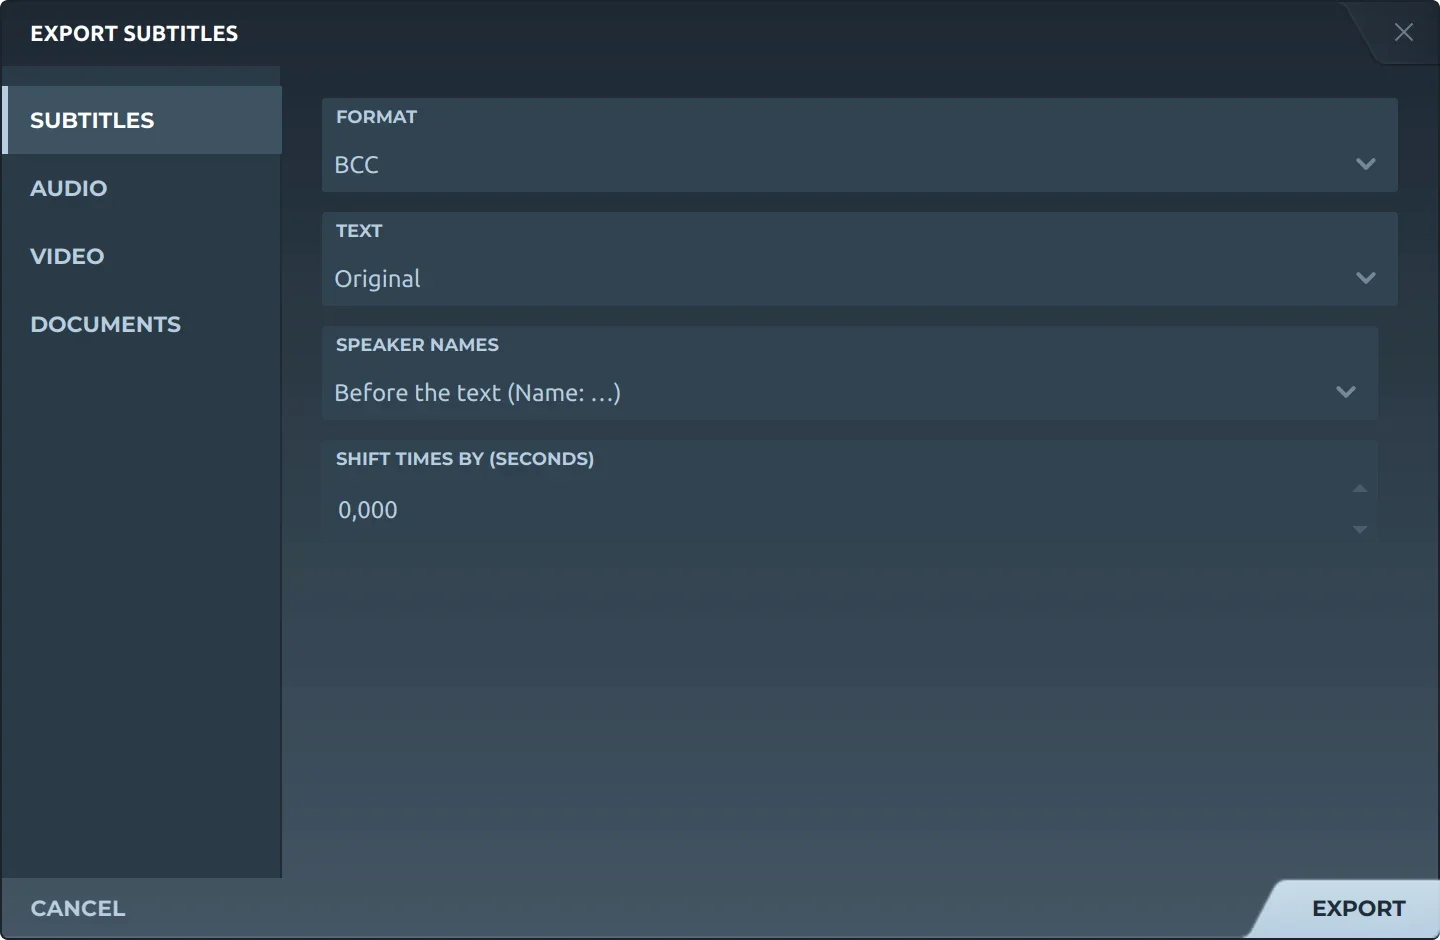
Exporter, puis Sous-titres, propose les deux :
- JSONCelui de Subtitld : le projet tel qu'il est, chaque sous-titre et chaque champ.
- BCCCelui de Bilibili : l'original, une traduction, ou les deux, la traduction en dessous ; noms des locuteurs omis ou avant le texte ; temps décalés si vous le choisissez.
Anecdotes
La norme JSON, RFC 8259 de 2017, veut que le JSON échangé entre systèmes soit en UTF-8.
Tics par seconde dans les transcriptions d'Azure : il compte le temps en centaines de nanosecondes.
Secondes pendant lesquelles le lecteur de YouTube affiche un sous-titre json3 qui ne dit pas combien de temps il dure.
Formats associés
Ouvrez-le dans Subtitld avec la vidéo et recalez-le sur la forme d'onde.