
JSON-Untertitel und Transkripte
Kein einzelnes Format, sondern viele: JSON ist die Art, wie Spracherkennungsdienste, Videoplattformen und Untertitelseiten Untertitel und Transkripte weitergeben, jede in einer eigenen Form. Subtitld speichert seine eigene, in der Form, die Whisper schreibt, mit allem, was ein Untertitel enthält, und öffnet, was ein Dutzend andere Werkzeuge schreiben.
Auf einen Blick
| Dateiendung | .json |
|---|---|
| Medientyp | application/json |
| Spezifikation | JSON selbst: RFC 8259 und ECMA-404. Die Form jedes Werkzeugs ist eigen. |
| Zeitgenauigkeit | Die von Subtitld: Sekunden, auf die Millisekunde genau. Andere: Millisekunden, Sekunden, Ticks zu 100 Nanosekunden oder Text wie "1.400s". |
| Textkodierung | UTF-8 |
| Gestaltung | Die von Subtitld: die Tags, die sein Text behält. Die von YouTube: fett, kursiv, unterstrichen und Farben. Die übrigen: keine. |
| Positionierung | Die von Subtitld: im Text, als {\an8}. Die von YouTube: Fenster. Die von Bilibili: eine Lage. |
| Sprecher | Subtitlds speaker; Spracherkennungsdienste kennzeichnen ihre eigenen |
| In Containern | Keine |
Aufbau der JSON von Subtitld
Was Subtitld für einen Untertitel speichert:
{
  "language": "en-us",
  "segments": [
    {
      "id": 0,
      "start": 23.0,
      "end": 24.5,
      "text": "You're a jerk, Thom.",
      "speaker": "Celia"
    }
  ],
  "text": "You're a jerk, Thom."
}| Teil | Was es ist |
|---|---|
"language" |
Die Sprache des Projekts, so wie Subtitld sie benennt (en-us) |
"segments" |
Die Untertitel, in Reihenfolge |
"id" |
Ihre Nummer, ab 0, so wie Whisper sie nummeriert |
"start", "end" |
Sekunden |
"text" |
Ihr Text, mit seinen Tags (<i>, {\an8}) und Zeilenumbrüchen (\n) |
"speaker", "translations" … |
Alles, was der Untertitel sonst enthält: sein Sprecher, seine Übersetzungen nach Sprache, seine Synchronisationen |
"text", am Ende |
Der ganze Text in einer Zeile, für Werkzeuge, die nur das wollen. Wird nicht zurückgelesen. |
Whispers Form, mit Absicht. Es ist das, was OpenAIs Whisper schreibt, damit Werkzeuge, die Whispers Segmente lesen, Subtitlds Dateien lesen können, und Subtitld öffnet Whispers Dateien, ohne die Statistiken seiner Dekodierung und die Zeiten einzelner Wörter.
Was Subtitld öffnet
Das JSON jedes Werkzeugs verrät über seine Schlüssel, welches es ist. Subtitld öffnet diese:
| Werkzeug | Was Subtitld daraus übernimmt |
|---|---|
| Subtitld, OpenAIs Whisper | Jedes Feld (von Subtitld); Text und Sprache (von Whisper) |
| whisper.cpp | Seine Segmente und seine Sprecher, wenn es die beiden Kanäle unterscheiden kann |
| WhisperX | Seine Segmente und Sprecher |
YouTube (.json3, wie yt-dlp es speichert) |
Text, fett, kursiv, unterstrichen, Farben und Platz |
Bilibili (.bcc) |
Text und Platz |
| AssemblyAI, Deepgram, AWS Transcribe, Rev.ai, Google Speech-to-Text, Azure Speech, Speechmatics | Wörter, Sprecher und Sprache, zu Untertiteln gemacht |
| Amara | Text, kursiv, fett, unterstrichen, und Untertitel oben |
Eine JSON-Datei, die keines davon ist, meldet das. Eine Datei, die kein gültiges JSON ist, nennt Zeile und Spalte des Fehlers.
Transkripte in Untertitel
Spracherkennungsdienste liefern Wörter mit ihren Zeiten oder lange Redeabschnitte. Subtitld macht daraus Untertitel, soweit es die Grenzen der Qualitätsprüfung erlauben: Zeichen je Zeile, Zeilen und Sekunden. Ein Untertitel endet:
- wo der Sprecher wechselt oder die Sprache länger als eine Sekunde pausiert;
- am Satzende, wenn der nächste Satz die Zeile über eine Zeile hinaus füllen würde;
- wenn er voll ist: an seinem letzten Satzzeichen, das ihn noch angemessen füllt, sonst zwischen zwei Wörtern.
Ein Abschnitt ohne Wortzeiten wird ebenso verteilt, seine Zeit nach der Länge seiner Teile.
Legen Sie die Grenzen zuerst fest. Untertitel werden beim Öffnen der Datei erstellt: Ändern Sie die Grenzen unter Qualitätsprüfung, bevor Sie ein Transkript öffnen, um längere oder kürzere zu erhalten.
Sprecher und Sprachen
Dienste nummerieren ihre Sprecher: 0, spk_1, SPEAKER_02, S3. Subtitld nennt sie A, B, C … in der Reihenfolge, in der sie zum ersten Mal sprechen, wie es Sprecher selbst benennt; ein Sprecher, den eine Datei benennt, wie Rev.ai es kann, behält den Namen.
Die Sprache des Projekts stammt aus der Datei, als Code (en_us, pt) oder als Name (English, wie Whisper ihn behält, wenn man es darum bittet), oder sonst aus dem Dateinamen: video.en.json3. Eine Datei in der Sprache des Projekts behält das Land des Projekts: pt in einem pt-br-Projekt bleibt pt-br.
YouTubes json3
Was YouTubes Player liest und yt-dlp als .json3 speichert: Ereignisse mit Text in Millisekunden, mit Stiften für fett, kursiv, unterstrichen und Farben, sowie Fenstern für ihren Platz. Automatische Untertitel laufen durch, Zeile nach Zeile, jede bis zum Erscheinen der nächsten angezeigt; Subtitld macht jede Zeile zu einem Untertitel, bis die nächste beginnt.
Bilibilis BCC
Was Bilibilis Player liest, und das andere JSON, das Subtitld speichert.
{
  "font_size": 0.4,
  "font_color": "#FFFFFF",
  "background_alpha": 0.5,
  "background_color": "#9C27B0",
  "Stroke": "none",
  "body": [
    {
      "from": 23.0,
      "to": 24.5,
      "location": 2,
      "content": "You're a jerk, Thom."
    }
  ]
}
Zeiten sind Sekunden; content ist reiner Text, seine Zeilen durch \n getrennt. Das Aussehen oben ist das, das Bilibilis eigene Dateien enthalten, und Subtitle Edit schreibt es ebenfalls.
Ein Untertitel nach dem anderen. Untertitel, die zur selben Zeit angezeigt werden, werden zu einem Eintrag, ihre Texte jeweils eine Zeile, sodass die Zeitleiste keine Überschneidungen hat. location ist immer 2, die Mitte unten: Es ist nicht bekannt, dass Bilibilis Player damit Untertitel anderswo platziert.
JSON in Subtitld
- Text, Formatierung und Platz jedes Untertitels
- Sprecher, Übersetzungen und Synchronisationen
- Beginn und Ende, auf die Millisekunde genau
- Die Sprache des Projekts
- Wortzeiten und wie sicher ein Dienst sich bei jedem war
- Die Statistiken von Whisper über seine Dekodierung
- Schriften, Größen, Kanten und Hintergründe von YouTube
- In BCC: Formatierung, Platz und Übersetzungen neben dem Original
Speichern Sie ein .usfx-Projekt, um das zu behalten, was zu Subtitld gehört.
Exportieren
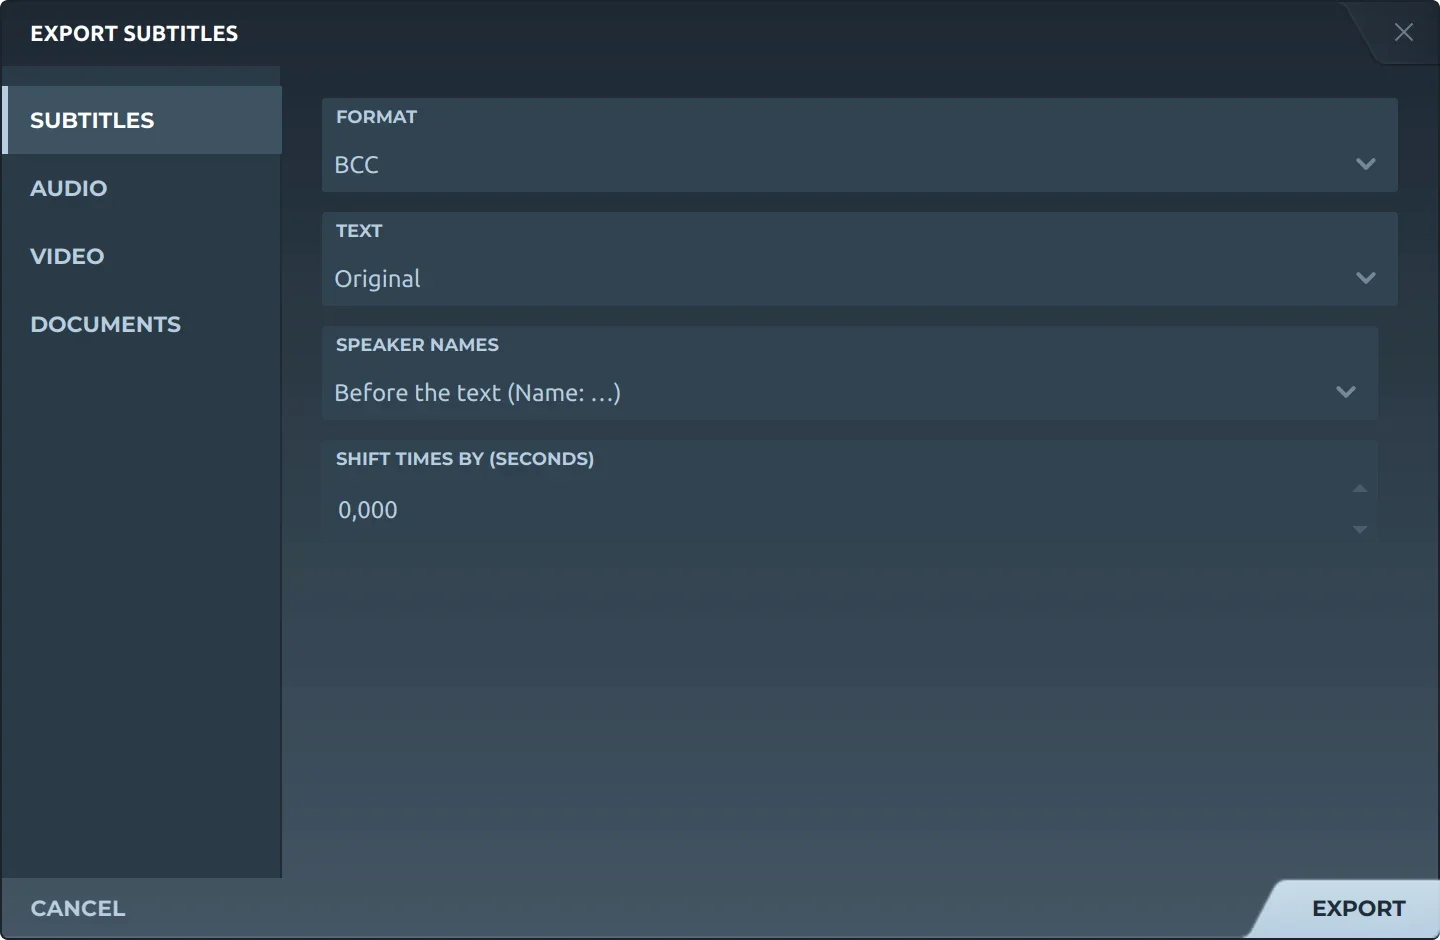
Export, dann Untertitel, bietet beide an:
- JSONDas von Subtitld: das Projekt, wie es ist, jeder Untertitel und jedes Feld.
- BCCDas von Bilibili: das Original, eine Übersetzung oder beides, die Übersetzung darunter; Sprechernamen weggelassen oder vor dem Text; Zeiten verschoben, wenn Sie es wählen.
Wissenswertes
JSONs Standard, RFC 8259 von 2017, verlangt, dass JSON zwischen Systemen in UTF-8 gesendet wird.
Ticks pro Sekunde in den Transkripten von Azure: Die Zeit wird in Hundert-Nanosekunden gezählt.
Sekunden, die YouTubes Player eine json3-Untertitelzeile anzeigt, wenn sie nicht angibt, wie lange sie dauert.
Verwandte Formate
Öffnen Sie sie in Subtitld mit dem Video und passen Sie die Zeiten an der Wellenform an.